actions/setup-node:版本檔案、自動開啟的快取
actions/setup-node 安裝 Node.js 版本、將其加入 PATH、可以還原套件管理器的全域快取,並可以寫入 .npmrc 以進行發佈。從 v6 開始,當 package.json 指定 npm 作為套件管理器時,它會自動快取 npm;而從 v7(目前為 v7.1.0)開始,當設定 registry-url 時不再匯出佔位用的 NODE_AUTH_TOKEN。

setup-node v7 是否執行快取,以及執行時使用的快取金鑰。僅限完全符合,僅在作業成功時才儲存。
大多數工作流程都會從其他地方複製 setup-node 步驟,其中包含沒有人檢查過的 cache: npm 這一行。當主要版本更新時,有些行為就會改變:快取自動開啟、使用 pnpm 的專案在 pnpm 安裝前就失敗,或是 OIDC 發佈因為沒有人設定的 token 而中斷。
其中兩個改變來自快取機制,其規則在 v5 到 v6 之間的兩個月內變更了兩次;另一個來自發佈行為,v7 停止匯出佔位 token。如果你的工作流程早於 v6,請在更新版本前先閱讀快取相關章節。
輸入參數,以及兩個新的快取輸出
表格內容來自 v7.1.0 標籤的 action.yml。會回傳四個輸出值:node-version、cache-hit,以及 v7 新增的 cache-primary-key 和 cache-matched-key,讓後續步驟能確切知道還原了哪個快取項目。快取會在 action.yml 限制為 success() 的 post 步驟中儲存,因此失敗的作業不會為下次執行儲存任何快取。
permissions:
  contents: read
steps:
  - uses: actions/checkout@3d3c42e5aac5ba805825da76410c181273ba90b1 # v7.0.1
    with:
      persist-credentials: false
  - uses: actions/setup-node@949feb2413d6458794dcd2491c4babbbce0c15c1 # v7.1.0
    with:
      node-version-file: .nvmrc
      cache: npm
  - run: npm ci
  - run: npm test
Enter fullscreen mode
Exit fullscreen mode
| 輸入參數 | 預設值 | 功能說明 |
|---|---|---|
node-version |
無 | 版本規格:24、22.17.1、lts/*、latest。優先於 node-version-file
|
node-version-file |
無 |
.nvmrc、.node-version、.tool-versions、mise.toml 或 package.json
|
architecture |
執行器的架構 |
x86、x64 等;除非設定 node-version,否則會被忽略並顯示警告 |
check-latest |
false |
尋找比快取版本更新但仍符合規格的版本 |
registry-url |
無 | 寫入 .npmrc,其中的認證行會讀取 NODE_AUTH_TOKEN
|
scope |
無;針對 npm.pkg.github.com 則為存放庫擁有者 |
限定範圍的 registry 的 scope |
token |
github.token(在 github.com 上) |
從 actions/node-versions 下載 Node 建置檔 |
cache |
無 |
npm、yarn 或 pnpm
|
package-manager-cache |
true |
設為 false 以停用自動 npm 快取 |
cache-dependency-path |
無 | 用於快取金鑰的 lockfile 路徑、glob 或清單 |
mirror |
無 | Node 二進位檔的替代來源 |
mirror-token |
無 | 作為 Authorization 標頭傳送給 mirror |
輸入與輸出來自 actions/setup-node action.yml v7.1.0 標籤(commit 949feb2413d6458794dcd2491c4babbbce0c15c1),讀取於 2026-11-12。
node-version 或 node-version-file
請設定其中一個。若同時設定兩者,動作會發出警告「Both node-version and node-version-file inputs are specified, only node-version will be used」並忽略檔案。若兩者皆未設定,則使用 PATH 上已有的 Node 版本,該版本會隨執行器映像檔更新而改變。
相對路徑的 node-version-file 會相對於 GITHUB_WORKSPACE 解析,而非步驟的工作目錄;v7.1.0 也接受絕對路徑,因此複合動作可以傳入自己的檔案。對於 package.json,動作會先讀取 volta.node,接著是名為 node 的 devEngines.runtime 項目,然後是 engines.node,最後追蹤 volta.extends。若檔案可讀但無法解析,會記錄警告並繼續使用 PATH 上的 Node;node version file 頁面說明如何將其轉為失敗。
解析時會先檢查執行器工具快取中是否有符合 semver 的版本,接著從 actions/node-versions 下載,再從 nodejs.org 下載。check-latest: true 會在有更新的符合版本時跳過快取版本,但代價是需要下載。
內建快取,以及何時執行
由三個問題決定。若設定了 cache,動作會快取該套件管理器(必須已安裝):在 pnpm 進入 PATH 前使用 cache: pnpm 會導致步驟失敗。若未設定,且 package-manager-cache 保持為 true,則僅在 package.json 的 devEngines.packageManager 或最上層 packageManager 欄位指定 npm 時才快取 npm。否則不會快取任何東西。
它儲存的是套件管理器的全域快取目錄,而非 node_modules,因此 npm ci 仍會執行並建置依賴樹。快取金鑰為 node-cache-<platform>-<arch>-<manager>-<hash>,由 lockfile 產生,還原時必須完全符合:只要改動一個依賴,下次執行就會從頭開始。唯一例外是所有依賴皆由本地管理的 Yarn Berry 專案,可能會以字首還原較舊的項目。
若有多個 lockfile,請將 cache-dependency-path 指向 glob 或清單。關於真實專案中使用快取的實際效益,可參考加快 npm install 中的實測數據。
steps:
  - uses: actions/checkout@3d3c42e5aac5ba805825da76410c181273ba90b1 # v7.0.1
    with:
      persist-credentials: false
  - uses: pnpm/action-setup@73e46992e05b19abd31f2f3c20e0e7370d762115 # v6.1.1
    with:
      version: 10
  - uses: actions/setup-node@949feb2413d6458794dcd2491c4babbbce0c15c1 # v7.1.0
    with:
      node-version: 24
      cache: pnpm
      cache-dependency-path: |
        apps/web/pnpm-lock.yaml
        apps/api/pnpm-lock.yaml
Enter fullscreen mode
Exit fullscreen mode
快取規則來自 setup-node v7.1.0 的 src/main.ts、src/cache-restore.ts 與 src/cache-utils.ts,讀取於 2026-11-12。
快取規則在兩個月內變更兩次
快取規則在兩個月內變更了兩次。v5 對任何 packageManager 欄位都開啟快取,導致宣告 pnpm 並在之後用 corepack 安裝的專案在 Set up Node.js 階段(corepack 執行前)就失敗(issue 1357)。v6 則將自動快取限制為 npm。
| 版本 | 發佈日期 | 變更內容 | 建議做法 |
|---|---|---|---|
| v4.0.0 | 2023-10-23 | 執行環境從 node16 改為 node20 | 託管執行器無需任何動作 |
| v5.0.0 | 2025-09-04 | 執行環境改為 node24;當設定 packageManager 時預設開啟快取 |
自託管機器需使用 v2.327.1 或更新版本的執行器 |
| v6.0.0 | 2025-10-14 | 自動快取限制為 npm;移除 always-auth 輸入參數 |
明確加入 cache: pnpm 或 cache: yarn;刪除 always-auth |
| v7.0.0 | 2026-07-14 | 移除佔位 NODE_AUTH_TOKEN;新增 cache-primary-key 與 cache-matched-key 輸出;內部改用 ESM |
在需要 registry 的地方自行設定 NODE_AUTH_TOKEN |
| v7.1.0 | 2026-10-08 | 支援 mise.toml;支援絕對 node-version-file 路徑;版本驗證與 manifest 擷取重試 |
無需任何動作 |
摘自 actions/setup-node 發佈說明以及 README 中的「What’s new in V7」與「Breaking changes」章節,讀取於 2026-11-12。
registry-url、NODE_AUTH_TOKEN 與發佈
action.yml 說明 registry-url 會寫入專案層級的 .npmrc。v7.1.0 的原始碼會將其寫入 $RUNNER_TEMP/.npmrc 並匯出指向該檔案的 NPM_CONFIG_USERCONFIG,因此不會影響你存放庫自己的 .npmrc。寫入的認證行為 //registry.npmjs.org/:_authToken=${NODE_AUTH_TOKEN}:token 會在發佈時從該步驟的環境中讀取,因此請將 NODE_AUTH_TOKEN 設定在執行發佈的步驟上。
在 v7 之前,若未設定 token,動作會匯出佔位用的 NODE_AUTH_TOKEN=XXXXX-XXXXX-XXXXX-XXXXX。v7 已移除此行為,README 也警告使用 Yarn Classic 或較舊 npm 時,若設定 registry-url 但沒有 token 可能會失敗。npm trusted publishing 完全不需要 token:需使用 npm 11.5.1 或更新版本、設定 id-token: write,並在 npm 上設定與存放庫和工作流程完全符合的 trusted publisher,否則發佈會回傳 E404。
setup-node 文件在所有發佈範例中都設定 package-manager-cache: false,因為持有發佈憑證的作業若有遭污染的快取,可能會導致憑證外洩。請務必比照辦理。
permissions:
  contents: read
  id-token: write
steps:
  - uses: actions/checkout@3d3c42e5aac5ba805825da76410c181273ba90b1 # v7.0.1
    with:
      persist-credentials: false
  - uses: actions/setup-node@949feb2413d6458794dcd2491c4babbbce0c15c1 # v7.1.0
    with:
      node-version: 24
      registry-url: https://registry.npmjs.org
      package-manager-cache: false
  - run: npm ci
  - run: npm publish
Enter fullscreen mode
Exit fullscreen mode
遺失檔案、遺失 lockfile 與遺失 pnpm
前兩項已有完整說明頁面,其餘為一行修正。步驟之後、在安裝本身發生的失敗屬於另一類問題:常見的兩種為 npm ci lockfile out of sync 與 no pnpm version is specified。
| 訊息 | 原因 | 修正方式 |
|---|---|---|
The specified node version file at: <path> does not exist |
輸入路徑與 GITHUB_WORKSPACE 合併後找不到檔案 |
Node version file does not exist |
Dependencies lock file is not found in <workspace>. Supported file patterns: package-lock.json,npm-shrinkwrap.json,yarn.lock |
設定了 cache 但根目錄下沒有 lockfile |
Dependencies lock file is not found |
Some specified paths were not resolved, unable to cache dependencies. |
cache-dependency-path 沒有比對到任何路徑 |
修正 glob;其路徑相對於 workspace |
Unable to find Node version '<spec>' for platform <os> and architecture <arch>. |
該平台上沒有符合規格的已發佈建置檔 | 檢查規格與架構 |
Unable to locate executable file: pnpm. |
cache: pnpm 在 pnpm 安裝前就執行 |
將 pnpm 安裝步驟移到 setup-node 之前 |
常見問題
actions/setup-node 會快取 node_modules 嗎?
不會。它快取的是套件管理器的全域快取目錄(npm 為 ~/.npm),並以 lockfile 的雜湊值作為金鑰,因此 npm ci 仍會執行並建置 node_modules。setup-node 文件說明原因:全域快取可在不同 Node 版本間重複使用,因此三個版本的 matrix 可以共用同一個快取項目。
為什麼使用 pnpm 時 setup-node v5 會立刻失敗?
v5 只要 package.json 有 packageManager 欄位就會開啟快取,因此宣告 pnpm 的專案會讓動作在任何後續步驟安裝 pnpm 之前就尋找 pnpm(issue 1357)。v6 將自動快取限制為 npm。建議升級,或在 v5 上設定 package-manager-cache: false。
為什麼在 setup-node 設定 registry-url 後,npm OIDC 發佈會失敗?
直到 v6 為止,當你沒有設定 token 時,動作會匯出 NODE_AUTH_TOKEN=XXXXX-XXXXX-XXXXX-XXXXX,而要求移除此預設值的 issue(issue 1440)描述了必須將其清空才能讓 OIDC 發佈正常運作。v7.0.0 已移除此佔位符。在 v7 上,請確認 npm 版本為 11.5.1 或更新,並確認 trusted publisher 與工作流程檔案完全相符。
為什麼 GITHUB_TOKEN 無法從另一個存放庫安裝私人套件?
因為套件僅能被其設定允許的工作流程讀取。setup-node 文件指向套件設定的「Manage Actions access」,在此處加入允許讀取的工作流程所在的存放庫;之後 NODE_AUTH_TOKEN: ${{ secrets.GITHUB_TOKEN }} 就能在同組織內的套件上運作。
參考資料
原文發表於 CodingCush。
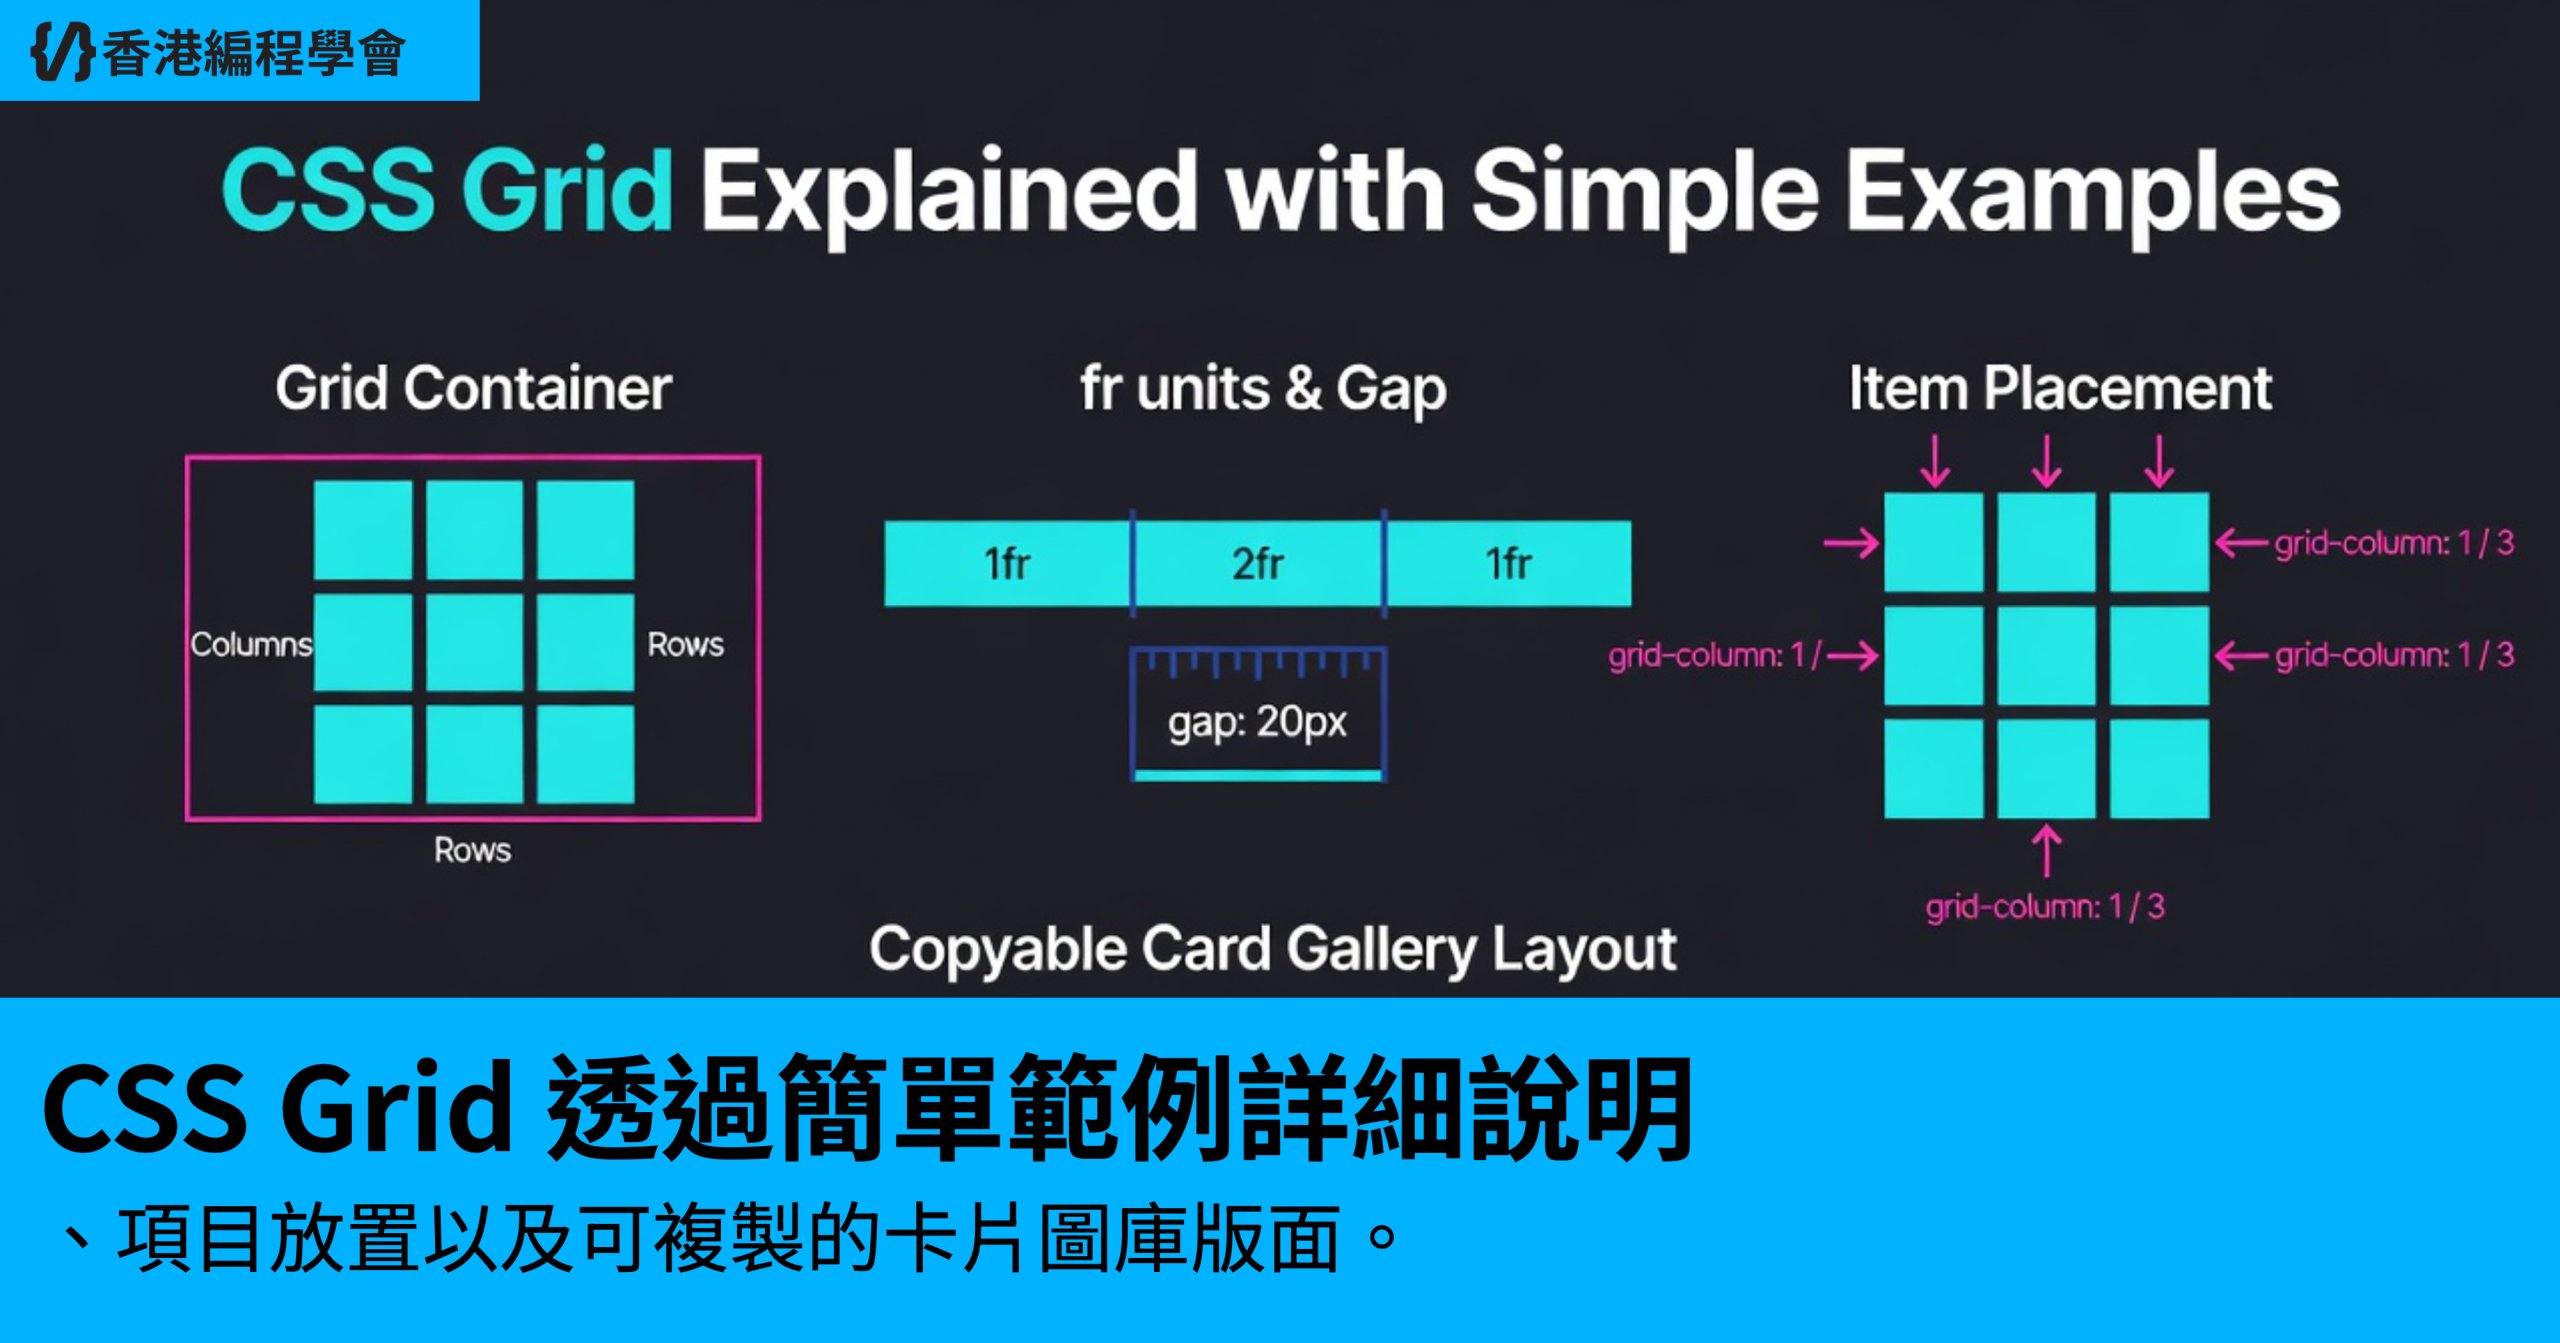
CSS Grid 是內建於 CSS 的版面配置系統,能讓你同時以列和欄的方式放置項目。你只要在父元素上設定 display: grid 就能將它變成網格容器,定義欄與列,使用 gap 加入間距,瀏覽器就會自動幫你對齊所有內容。在這篇指南中,你將逐步學習核心概念,打造一個可直接複製的完整卡片圖庫,並了解什麼時候 Grid 比 Flexbox 更適合。
什麼是網格容器?
每個網格都從容器開始。選擇包住你項目的元素,可以是 div、section 或 main,然後在它上面設定 display: grid。這一行程式碼就會改變其直接子元素的行為。子元素會變成網格項目,而容器則控制它們的位置。
可以把它想像成試算表。欄垂直排列,列水平排列,每個項目都位於列與欄交會的格子中。線是格子之間的邊界,而軌道就是列和欄本身。你描述這個試算表,瀏覽器就會幫你建立它。
如果你還在搞不清楚網頁上各種語言各自負責什麼,我們的 HTML、CSS 與 JavaScript 的差異 指南是個友善的起點。HTML 提供結構,CSS(包含 Grid)則負責版面配置。
MDN 網格版面配置基本概念指南 詳細解釋了容器、項目、線與軌道,練習時值得加入書籤。
步驟 1:建立你的第一個網格
從簡單的 HTML 和一條 CSS 規則開始:
<div class="box">
  <div>One</div>
  <div>Two</div>
  <div>Three</div>
</div>

.box {
  display: grid;
}
進入全螢幕模式
退出全螢幕模式
這已經是一個真正的網格了。沒有定義欄的情況下,Grid 會建立一個欄,並將三個項目堆疊成三列。當你自己描述欄與列時,真正的魔法才開始。
步驟 2:定義欄與列
兩個屬性完成了大部分的工作。grid-template-columns 設定有多少欄以及每欄的寬度。grid-template-rows 則對列做相同的事。
.box {
  display: grid;
  grid-template-columns: 200px 200px 200px;
  grid-template-rows: 100px 100px;
}
進入全螢幕模式
退出全螢幕模式
這表示:建立三個欄,每欄 200 像素寬,以及兩個列,每列 100 像素高。六個項目會完美填滿。如果有第七個項目,會自動建立新的一列,這很方便,但也常讓人感到意外。
固定尺寸很清楚,但無法適應不同螢幕。這就是為什麼 Grid 有一個專門為此設計的單位。
步驟 3:認識 fr 單位
fr 單位代表可用空間的一個分數。它是 Grid 專屬的單位,能讓欄公平分享空間,而你不需要做任何數學計算。
grid-template-columns: 1fr 1fr 1fr;
進入全螢幕模式
退出全螢幕模式
這裡的可用空間被分成三等分。改成 2fr 1fr,第一個欄就會得到第二個欄的兩倍空間。這就像切蛋糕,其中一位客人禮貌且正確地拿到較大的一塊。
重複寫相同的數值很無聊,所以可以使用 repeat():
grid-template-columns: repeat(3, 1fr);
進入全螢幕模式
退出全螢幕模式
這一行與 1fr 1fr 1fr 意思相同,但更簡短也更容易修改。完整的 MDN CSS grid layout 參考 列出了你學習過程中會遇到的每一個 Grid 屬性。
步驟 4:使用 gap 加入間距
項目彼此緊貼會顯得擁擠。gap 屬性會在列與欄之間加入空間,而且只加在它們之間,絕不會加在外側邊緣。
.box {
  display: grid;
  grid-template-columns: repeat(3, 1fr);
  gap: 16px;
}
進入全螢幕模式
退出全螢幕模式
一個數值會同時設定兩種間隙。兩個數值則分別設定:gap: 24px 16px 表示列之間 24 像素,欄之間 16 像素。在 gap 出現之前,開發者得使用 margin 並手動修正外側多餘的空間。Grid 省去了這個麻煩。

本文的終端機風格程式碼清單:圖庫 CSS 規則、測試檔案的驗證檢查,以及 900 像素容器的版面測量結果。
步驟 5:使用 grid-column 放置項目
預設情況下,每個項目佔用一個格子並依序排列。有時候某個項目需要更多空間,例如圖庫頂部的精選卡片。此時可以在該項目上使用 grid-column:
.featured {
  grid-column: span 2;
}
進入全螢幕模式
退出全螢幕模式
span 2 表示這個項目要橫跨兩個欄。你也可以指定確切的線:grid-column: 1 / 3 表示從第 1 條線開始,到第 3 條線結束,寬度相同。初學者通常覺得 span 比較容易,所以從這裡開始。對應列的屬性是 grid-row。
良好的結構對 Grid 也有幫助。使用有意義的元素來製作區塊和卡片,正如我們 HTML 語意標籤透過範例詳細說明 指南中所介紹的,能讓你的標記保持清晰,而 Grid 則負責處理視覺上的排列。
步驟 6:一個可直接複製的完整卡片圖庫
現在把所有東西結合起來。這是本文實際測試過的完整範例。它建立了一個包含一張寬版精選卡片和四張一般卡片的圖庫:
<div class="gallery">
  <article class="card featured">
    <h2>Featured</h2><p>Wide card.</p>
  </article>
  <article class="card"><h2>Card 2</h2><p>Normal card.</p></article>
  <article class="card"><h2>Card 3</h2><p>Normal card.</p></article>
  <article class="card"><h2>Card 4</h2><p>Normal card.</p></article>
  <article class="card"><h2>Card 5</h2><p>Normal card.</p></article>
</div>

.gallery {
  display: grid;
  grid-template-columns: repeat(3, 1fr);
  gap: 16px;
  max-width: 900px;
  margin: 0 auto;
}
.card {
  background: #eef6ff;
  padding: 20px;
  border-radius: 8px;
}
.featured {
  grid-column: span 2;
}
進入全螢幕模式
退出全螢幕模式
以下是實際發生的事。圖庫有三個等寬的欄。在 900 像素的容器中,每個欄寬 289.33 像素,因為兩個 16 像素的間隙先用了 32 像素:(900 減 32) 再除以 3。精選卡片橫跨兩個欄,因此寬度為 594.67 像素。第一列放置精選卡片和 Card 2。第二列放置 Card 3、4 和 5。沒有使用 float,也不需要額外的 wrapper div。
我們在獨立的 HTML 檔案中驗證了這個範例:CSS 括號是平衡的,所有 Grid 屬性都存在,五個 article 元素也都正確地開關。試著把 repeat(3, 1fr) 改成 repeat(2, 1fr),觀察圖庫如何重新變成兩欄。
Grid 與 Flexbox:應該使用哪一個?
Grid 和 Flexbox 是朋友,而不是對手。Flexbox 只能單方向(列或欄)排列項目。Grid 則能同時處理兩個方向。如果你知道整個頁面的形狀,Grid 通常是更好的選擇。如果是一排需要換行和置中的項目,Flexbox 通常更簡單。我們的 companion 指南 CSS Flexbox 透過簡單範例詳細說明 以相同風格介紹了那種情況。
| 問題 | CSS Grid | Flexbox |
|---|---|---|
| 主要工作 | 以列和欄進行頁面版面配置 | 單一列或欄中的項目 |
| 方向 | 兩個:列與欄同時 | 一次一個 |
| 最適合 | 圖庫、儀表板、整個頁面 | 選單、工具列、置中項目 |
| 項目放置 | 可以將項目放在精確的格子中 | 項目依內容流動與調整大小 |
| 典型起點 | grid-template-columns |
justify-content 和 align-items
|
常見的模式是整個頁面使用 Grid,而每個卡片內部使用 Flexbox。
常見錯誤與疑難排解
在錯誤的元素上設定 display: grid。 Grid 只控制直接子元素。如果你的卡片被額外的 div 包住,那麼 wrapper 會變成項目,而不是卡片。先檢查你的 HTML 巢狀結構。
期待 gap 出現在外側。 gap 只在軌道之間加入空間。如果你想要整個網格周圍都有空間,請在容器上加入 padding。
搞混欄與列。 grid-template-columns 控制你閱讀方向的寬度。如果你的版面看起來被旋轉了,很可能是把兩個 template 屬性搞反了。
固定尺寸在小螢幕上溢出。 三個 200 像素的欄至少需要 600 像素加上間隙。在手機上就會溢出。建議使用 fr 單位來建立彈性欄位,並在窄寬度下測試。
忘記額外的項目會建立新列。 Grid 會為你沒預料到的項目自動加入列。當版面看起來比預期還高時,請檢查你的項目數量。
常見問題
CSS Grid 對初學者來說很難嗎?
不會。從 display: grid、grid-template-columns 和 gap 開始。這三個就足以打造大多數初學者版面,其餘的可以之後再學。
在 Grid 中 1fr 是什麼意思?
它代表扣除固定尺寸和間隙後,剩餘可用空間的一個分數。三個 1fr 的欄會平均分享該空間。
我應該先學 Grid 還是 Flexbox?
如果你主要要做置中項目和製作選單,先學 Flexbox 基礎,然後再學 Grid 來處理完整頁面版面。實際上你會同時使用兩者。
Grid 在所有現代瀏覽器中都能運作嗎?
可以。Grid 在所有現代瀏覽器中都受到支援,包括 Chrome、Firefox、Safari 和 Edge,因此本文的範例現在就可以安心使用。
如何讓網格項目橫跨兩列?
在該項目上使用 grid-row: span 2,就像 grid-column: span 2 橫跨兩欄一樣。
結論
一旦你把 Grid 看成一個被描述的試算表,它就不再可怕:一個容器、你定義的欄與列、公平分享空間的 fr 單位、提供呼吸空間的 gap,以及當某個項目需要更多空間時使用的 grid-column。複製這個圖庫,修改數字,並故意弄壞它來練習。
https://dev.to/kushkrg/css-grid-explained-with-simple-examples-39jb
https://www.worldprogramming.org/posts/css-grid-explained-with-simple-examples-e4rdrs
Microsoft 2026 年當機事件:給雲端工程師的 SRE 教訓
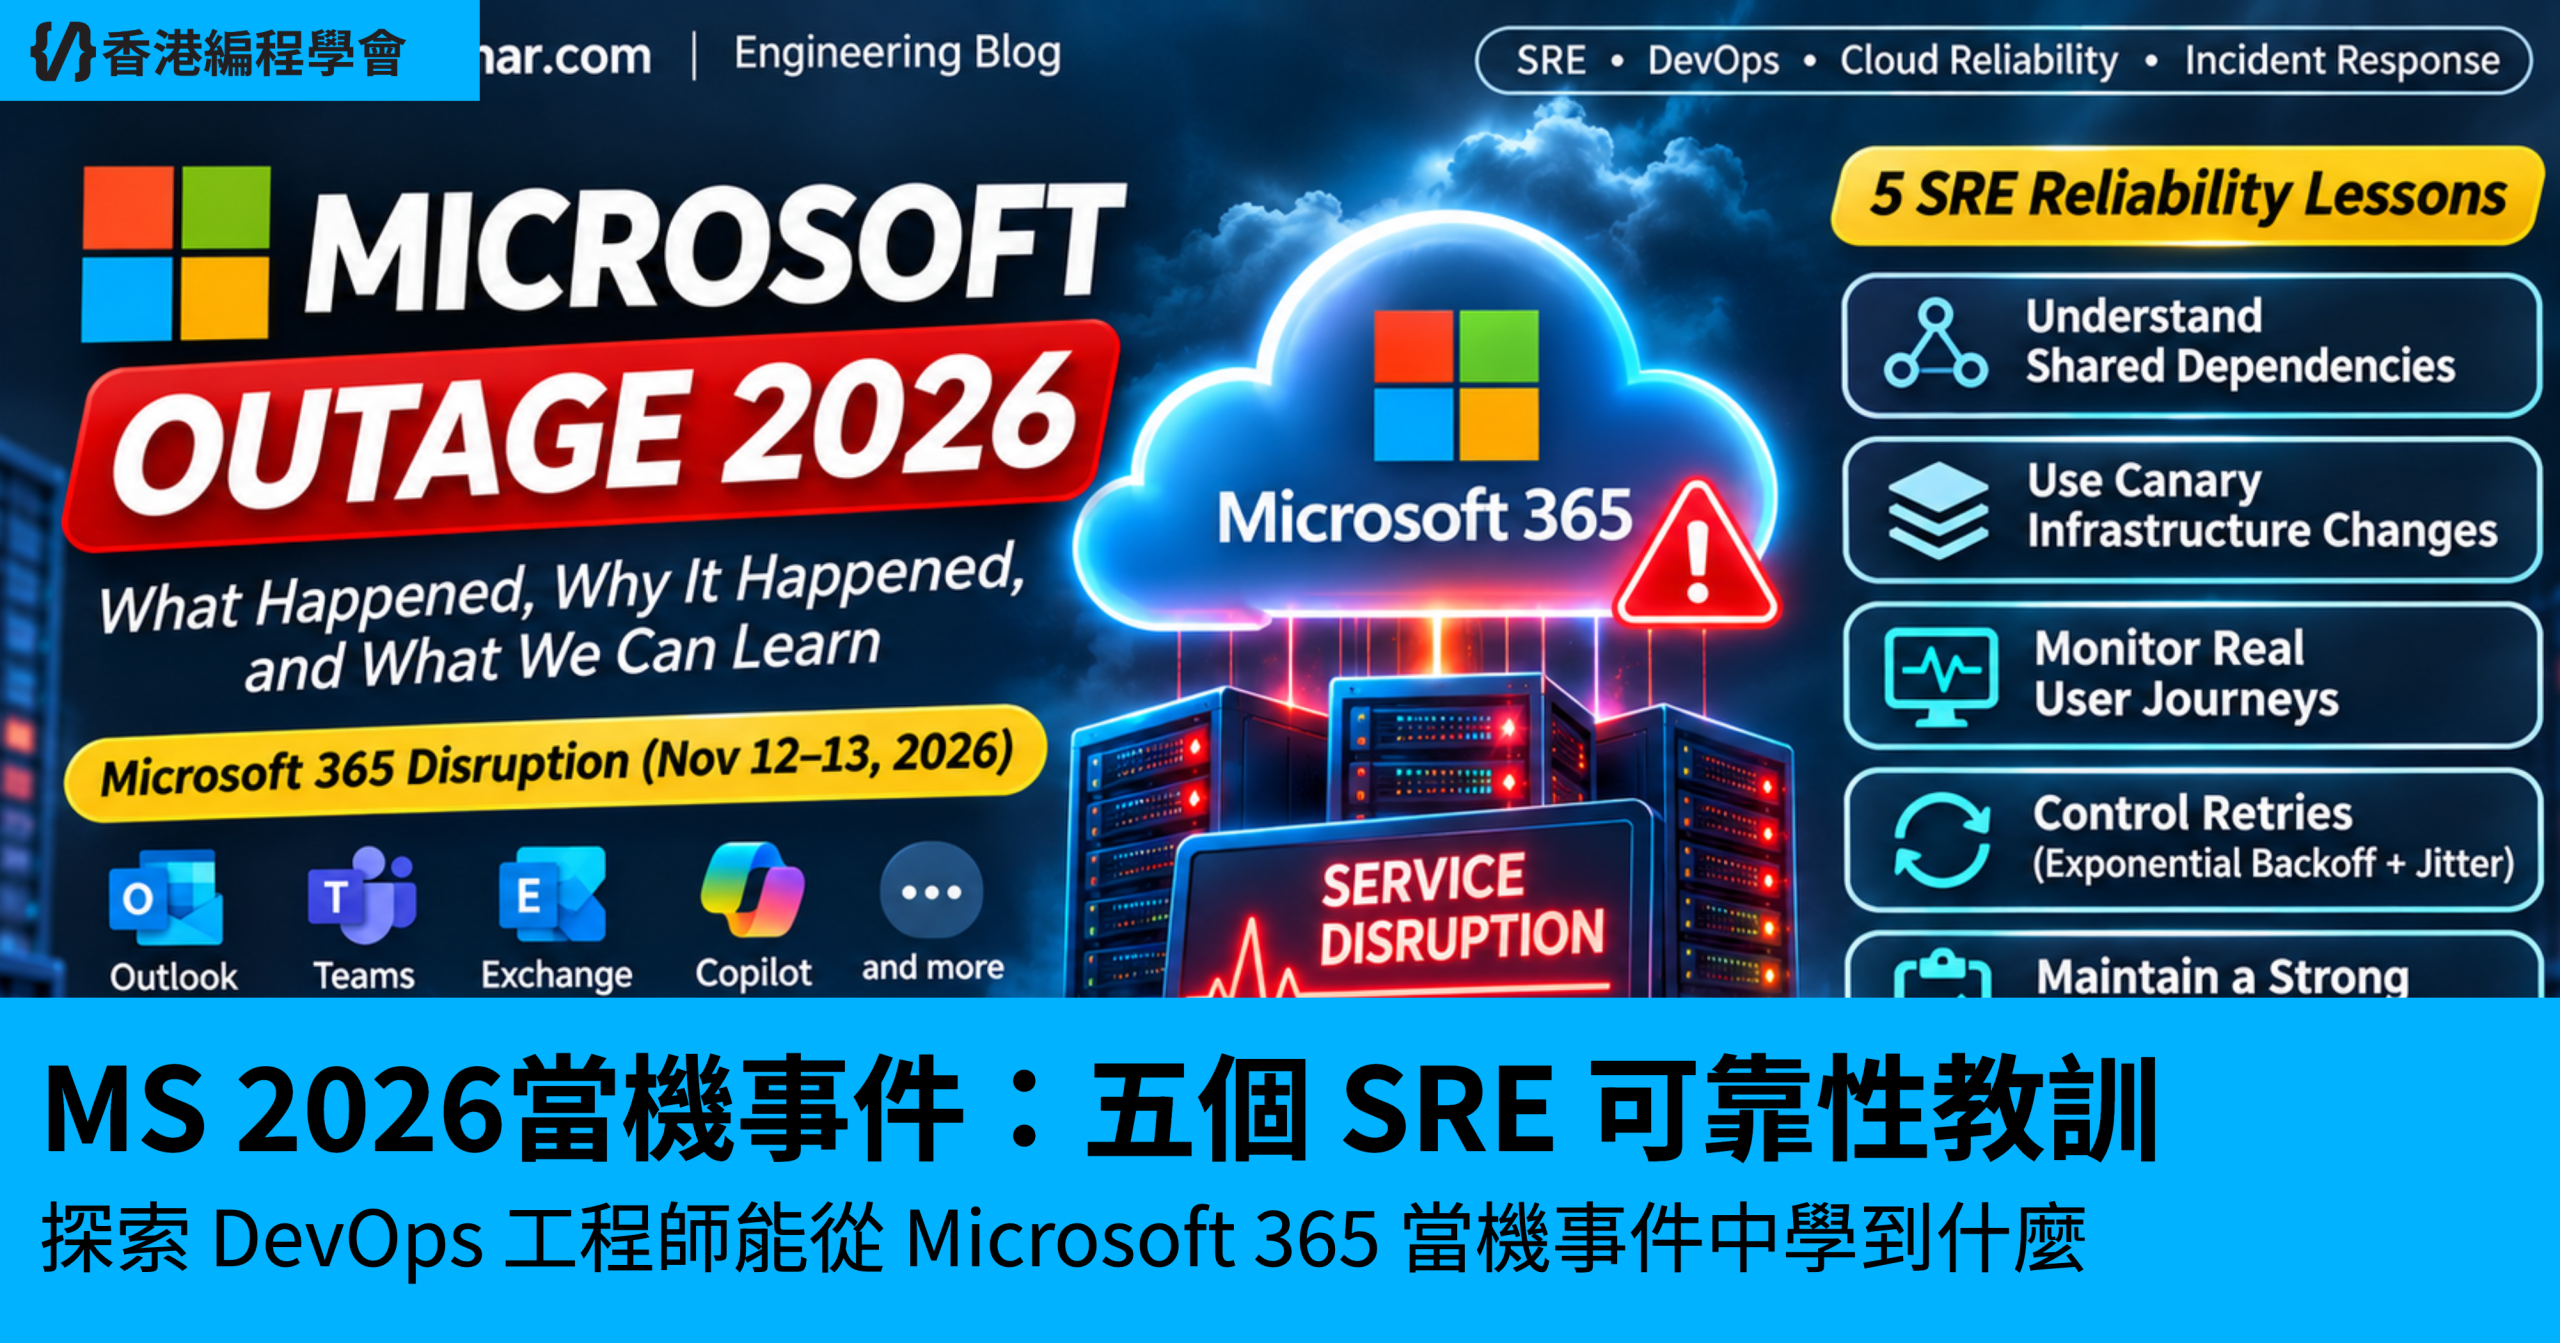
11 月 12–13 日的 Microsoft 當機事件中斷了 Microsoft 365 服務,包括 Outlook、Copilot,以及部分 Teams 功能。
Microsoft 將此次事件歸因於網路容量升級後的基礎設施問題。
確切的低階網路故障序列尚未公開完全驗證。
然而,有幾個重要的可靠性教訓十分突出。
1. 找出共享依賴
應用程式複本可能健康,但共享的身分驗證或網路服務卻發生故障。
繪製關鍵依賴及其故障域。
2. 使用漸進式基礎設施變更
分階段部署路由和平台設定。
監控每個階段,並在擴大變更前建立回滾條件。
3. 監控真實使用者工作流程
檢查使用者是否能進行身分驗證並完成重要交易。
不要只依賴伺服器健康指標。
4. 使用有界重試
復原期間,同步重試可能壓垮服務。
使用指數退避加上抖動、逾時,以及安全的重試上限。
5. 準備 SRE 事件操作手冊
定義事件所有權、升級、供應商溝通、復原驗證,以及後續行動。
閱讀完整指南
我的完整文章探討了 Microsoft 當機事件,以及用於雲端韌性、監控、網路變更管理與事件應變的實用 SRE 控制措施。
Read Microsoft Outage: Architecture & SRE Runbook
社群討論
針對共享雲端依賴故障,最重要的防護措施是什麼?
作者:Naveed Ahmed — DevOps & Platform Engineering
#SRE #DevOps #Microsoft365 #CloudReliability
https://www.worldprogramming.org/posts/microsoft-outage-2026-five-sre-reliability-lessons-hfu0mh
Supabase .NET SDK 是您 Supabase 專案的 C# 用戶端。
它透過單一 API 提供 Auth、Database、Storage、Realtime 和 Edge Functions,並處理與 Supabase 平台的通訊。
版本 8.0.0 已發佈,同時也推出了新的 Supabase.Extensions.DependencyInjection 套件。
本文將說明如何設定用戶端,並逐步介紹基本操作。
如果您是從先前的主要版本升級,有些部分已有所變動。
您不需要了解所有細節就能跟隨本教學,但值得知道以下事項:
- 序列化已從 Newtonsoft.Json 移至
System.Text.Json。自訂轉換器與[JsonProperty]屬性需改用System.Text.Json的對應功能。 - 每個服務用戶端現在都接受可注入的
HttpClient,並支援選擇性啟用重試與退避機制。 - 新增了適用於 ASP.NET Core 的相依性注入套件,下方會詳細說明。
- 套件目標為 .NET Standard 2.1。這表示不再支援 .NET Framework(其最高支援 .NET Standard 2.0),因此您需要 .NET Core 3.0+ 或 .NET 5+。
如果您想查看完整的變更清單,請查閱 發行說明。
遷移指南 列出了您可能遇到的所有重大變更以及處理方式。
將 meta-package 新增至您的專案。
它會引入所有五個服務套件(Auth、Postgrest、Storage、Realtime 和 Functions):
_10
dotnet add package Supabase
如果您只需要其中一個服務,請直接參考該套件,例如 Supabase.Gotrue 用於 Auth,或 Supabase.Postgrest 用於資料庫。
SDK 會將資料表對應至 C# 類別。
模型繼承自 BaseModel,並使用屬性將其屬性與欄位連結。
以下是我們將在後續範例中使用的 todos 資料表,包含 id、task 和 is_complete:
_15
using Supabase.Postgrest.Attributes;
_15
using Supabase.Postgrest.Models;
_15
_15
[Table("todos")]
_15
public class Todo : BaseModel
_15
{
_15
[PrimaryKey("id")]
_15
public int Id { get; set; }
_15
_15
[Column("task")]
_15
public string Task { get; set; }
_15
_15
[Column("is_complete")]
_15
public bool IsComplete { get; set; }
_15
}
ASP.NET Core#
安裝相依性注入套件:
_10
dotnet add package Supabase.Extensions.DependencyInjection
在 Program.cs 中註冊用戶端:
_14
using Supabase.Core.Http;
_14
using Supabase.Extensions.DependencyInjection;
_14
_14
var builder = WebApplication.CreateBuilder(args);
_14
builder.Services.AddSupabase(
_14
supabaseUrl: builder.Configuration["Supabase:Url"]!,
_14
supabaseKey: builder.Configuration["Supabase:Key"]!,
_14
configureOptions: options =>
_14
{
_14
options.AutoConnectRealtime = true;
_14
options.PostgrestRetry = new RetryOptions { MaxRetries = 3 };
_14
});
_14
_14
var app = builder.Build();
AddSupabase 會將 Supabase.Client 註冊為 scoped 服務,因此您可以在需要的地方注入它:minimal API endpoint、controller 或您自己的服務。
_13
using Supabase;
_13
_13
public class TodoService(Client supabase)
_13
{
_13
public async Task<List<Todo>> GetOpen()
_13
{
_13
var result = await supabase
_13
.From<Todo>()
_13
.Where(t => t.IsComplete == false)
_13
.Get();
_13
return result.Models;
_13
}
_13
}
它也會分別註冊每個子用戶端(IPostgrestClient、IGotrueClient<User, Session>、IStorageClient<Bucket, FileObject>、IFunctionsClient、IRealtimeClient<RealtimeSocket, RealtimeChannel>),因此只需碰觸單一服務的類別就能只依賴該服務。
我們建置這個擴充套件,讓您能輕鬆設定用戶端,而無需自己手動連接。
Supabase.Client 在建構時會自行建立 HttpClient。如果您以 scoped 或 transient 方式註冊,每次解析都會建立新的 HttpClient(以及新的 socket),在負載下會耗盡連線池。
AddSupabase 透過 IHttpClientFactory 來連接用戶端,讓處理程式能被共用與重用。
為了保持一致性,它會取代您透過 configureOptions 傳入的任何 HttpClient;您的 proxy、重試、Realtime 與其他選項仍然有效。
其他應用程式#
在 ASP.NET Core 之外的 Console 應用程式、Desktop、Mobile 或 Unity 中,請自行建構用戶端並只初始化一次:
_13
using Supabase;
_13
_13
var url = Environment.GetEnvironmentVariable("SUPABASE_URL")!;
_13
var key = Environment.GetEnvironmentVariable("SUPABASE_KEY")!;
_13
_13
var options = new SupabaseOptions
_13
{
_13
AutoRefreshToken = true,
_13
AutoConnectRealtime = true,
_13
};
_13
_13
var supabase = new Client(url, key, options);
_13
await supabase.InitializeAsync();
InitializeAsync 會還原已儲存的工作階段,並在開啟 AutoConnectRealtime 時建立 Realtime 連線。
預設的工作階段處理程式不會儲存任何資料,因此若要在重新啟動後還原登入,請將 SupabaseOptions.SessionHandler 設定為您自己實作的版本,用來儲存與載入工作階段。
請只建立一次用戶端並在應用程式中重複使用。
每次操作都建立新用戶端意味著每次都會建立新的 HttpClient,這與 DI 套件在伺服器上解決的問題相同。
以下範例會使用 supabase 變數,它是一個 Supabase.Client 實例。
查詢資料列#
From<T>() 會針對 T 所對應的資料表開啟查詢。
您可以使用 Where 進行篩選,然後呼叫 Get 來執行查詢。
Get 會回傳 ModeledResponse<T>,您可以在 Models 中找到資料列:
_10
ModeledResponse<Todo> result = await supabase
_10
.From<Todo>()
_10
.Where(t => t.IsComplete == false)
_10
.Get();
_10
List<Todo> todos = result.Models;
插入#
Insert 可以寫入單一模型或清單:
_10
await supabase.From<Todo>().Insert(new Todo { Task = "Write the launch notes", IsComplete = false });
更新與刪除#
更新實體有兩種方式,兩者都有效。
這取決於您是否已取得該資料列。
如果您已經取得模型,請修改其屬性並呼叫 Update。
從 Get 回傳的資料列會帶有自己的識別資訊,因此它知道要寫入哪一筆記錄:
_10
var result = await supabase.From<Todo>().Where(t => t.Id == 1).Get();
_10
var todo = result.Models.First();
_10
_10
todo.IsComplete = true;
_10
await todo.Update<Todo>();
_10
_10
await todo.Delete<Todo>();
如果您沒有模型,可以使用查詢建置器,這能省去一次 Get 查詢。
設定新的值、篩選資料列,然後執行:
_10
await supabase
_10
.From<Todo>()
_10
.Set(t => t.IsComplete, true)
_10
.Where(t => t.IsComplete == false)
_10
.Update();
_10
_10
await supabase
_10
.From<Todo>()
_10
.Where(t => t.IsComplete == true)
_10
.Delete();
雖然這看起來與 Entity Framework 的建置方式非常相似,但行為並不相同。
這裡沒有DbContext、沒有變更追蹤器,也沒有SaveChanges。
修改模型的屬性不會有任何作用,直到您呼叫Update,而且每次呼叫都是獨立的 HTTP 請求。
驗證使用者#
驗證功能位於 supabase.Auth。
使用電子郵件與密碼註冊並登入使用者:
_10
await supabase.Auth.SignUp("[email protected]", "a-secure-password");
_10
_10
var session = await supabase.Auth.SignIn("[email protected]", "a-secure-password");
當 AutoRefreshToken 啟用時,用戶端會在存取權杖到期前自動重新整理,並將其附加至您的資料庫與 Storage 呼叫,因此 Row-Level-Security 會套用至已登入的使用者。
相同的 supabase.Auth 介面也涵蓋 OAuth、magic links、電話與 SSO。
上傳檔案#
_10
await supabase.Storage
_10
.From("avatars")
_10
.Upload("./local/photo.png", "maria/photo.png");
版本 8.0.0 新增了可發佈的金鑰與秘密 API 金鑰,與現有的 anon 和 service 金鑰並存。
在任何會發佈給使用者的應用程式中使用可發佈金鑰或 anon 金鑰。
請將 secret 和 service 金鑰保留在伺服器上。
Service 金鑰會繞過 Row Level Security,因此不應放在用戶端應用程式中。
當您需要此等級的存取權時,請為其使用獨立的用戶端。
您現在已設定好用戶端,可以從 .NET 執行查詢、驗證與 Storage 操作。接下來您可以:
- 瀏覽 C# 參考文件 以取得完整 API。
- 閱讀 DependencyInjection 套件 README 以了解 ASP.NET Core 的詳細資訊。
- 查看 SDK 存放庫 以取得範例與更新日誌。
https://supabase.com/blog/getting-started-with-the-supabase-dotnet-sdk
https://www.worldprogramming.org/posts/getting-started-with-the-supabase-net-sdk-gquayn
過去幾個月,我花了更多時間與 AI 程式碼代理合作。它們速度快、實用,而且在許多情況下,它們能比手動操作更快地修復小錯誤或實作特定變更。
但在使用它們的過程中,我一直回到同一個問題:我如何知道圍繞修復的證據是否真的有意義?
很容易要求代理修改一些程式碼、執行測試,然後回傳綠燈結果。問題在於綠燈測試只告訴我最終版本通過了。它並不一定能告訴我該測試是否能夠偵測到原始的錯誤。
這個差異聽起來很小,但它非常重要。
想像一個 AI 代理修復了一個錯誤並新增了一個迴歸測試。最終測試執行通過,所以變更看起來不錯。現在想像我們拿完全相同的測試去對壞掉的程式碼版本執行,它在那裡也通過了。
在這種情況下,測試是綠燈的,但它並沒有真正證明錯誤已被修復。
這就是我想要更系統化處理的那種問題。
基本概念
原則很簡單:
壞掉的基準 + 迴歸探測 = 失敗
修復的結果 + 相同的迴歸探測 = 通過
如果相同的探測在壞掉的版本上失敗,而在修復的版本上通過,證據就會強得多。
如果它在兩個版本上都通過,那麼測試可能並沒有真正測試我們關心的錯誤。
這個想法成為我一直在建構的一個小型工具的基礎,叫做 AI Coding Agent Reliability Kit。
它是一個以 Linux 為優先的本地工作流程,用來以更強的機械化證據審查 AI 輔助的錯誤修復。
目標不是取代程式碼審查、安全審查或工程判斷。目標是讓圍繞 AI 生成修復所產生的證據更容易檢查且更難被誤解。
我希望從工作流程中獲得什麼
當我開始研究這個時,我不想要另一個只是執行指令並印出成功或失敗的包裝工具。
我想要一個能回答關於變更幾個問題的工作流程。
代理被允許修改什麼?
它是否停留在該範圍內?
最終驗證指令是否真的通過?
迴歸探測是否在壞掉的基準上失敗?
結果是否能在乾淨的重播中重現?
另一個人是否能在不需手動重建一切的情況下審查證據?
這些是基本問題,但一旦程式碼代理開始進行更大或更頻繁的變更,它們就會變得重要。
在代理開始前界定變更範圍
這個工具所做的事情之一,是在程式碼工作開始前定義任務和允許的路徑。
這很有用,因為代理有時能在修復請求問題的同時也修改不相關的檔案。最終結果可能仍然能運作,但變更範圍會變得比必要的大。
對於一個聚焦的錯誤修復,我通常想要一個清楚的邊界。
例如,如果任務只需要在一個來源檔案和一個迴歸測試中進行變更,那麼對不相關的 README、設定檔或其他套件的修改應該立即可見。
這個工具會追蹤宣告的範圍,並檢查最終變更是否停留在其中。
如果有東西在允許的邊界之外被改變,則會被回報,而不是默默接受結果。
只檢查最終結果是不夠的
一般的工作流程通常在類似以下的情況後結束:
pytest tests/test_bug.py
Enter fullscreen mode
Exit fullscreen mode
指令成功退出,所以任務被視為完成。
這很有用,但對於迴歸修復,我想要多一項資訊。
我想要知道當相同的探測對已知的壞掉基準執行時會發生什麼。
一個好的迴歸探測通常應該能區分這兩個狀態。
例如:
Broken version: FAIL
Fixed version:  PASS
Enter fullscreen mode
Exit fullscreen mode
這是比以下情況強得多的訊號:
Broken version: PASS
Fixed version:  PASS
Enter fullscreen mode
Exit fullscreen mode
第二個結果並不一定表示程式碼有錯。它表示證據很弱。
這個區別很重要。
工作流程不應該假裝一個測試證明了它並沒有證明的事情。
非區分性測試
這是我建構這個工具的主要原因之一。
一個測試看起來可能完全有效,卻仍然無法區分壞掉和修復的版本。
例如,想像一個函數應該要將兩個數字相乘,但目前卻是相加。
壞掉的程式碼可能看起來像這樣:
def calculate(a, b):
    return a + b
Enter fullscreen mode
Exit fullscreen mode
修復將它改成:
def calculate(a, b):
    return a * b
Enter fullscreen mode
Exit fullscreen mode
現在想像測試只檢查這個:
def test_calculate_exists():
    assert callable(calculate)
Enter fullscreen mode
Exit fullscreen mode
這個測試在修復後是綠燈的,但它在修復前也是綠燈的。
它證明了函數存在。它並沒有證明錯誤已被修復。
這種結果不應該被視為與真正的迴歸測試相同。
這個工具會偵測這種情況,並將證據回報為非區分性,而不是將最終的綠燈結果視為足夠。
範圍違規
我想要處理的另一種情況是,實際的程式碼變更是正確的,但允許範圍之外的東西被修改了。
這可能意外發生,或是因為自動化工作流程在執行期間碰觸到另一個檔案。
假設代理被允許修改:
src/formatter.py
tests/test_formatter.py
Enter fullscreen mode
Exit fullscreen mode
來源修復和測試可能都是正確的,但如果最終變更也修改了:
README.md
Enter fullscreen mode
Exit fullscreen mode
那麼工作流程應該另外回報這一點。
這裡的重要觀點是,正確性和範圍是不同的事情。
一個正確的來源修復並不會自動讓不相關的變更變得可接受。
這個工具會將這些關注點分開,讓審查者能清楚看到到底發生了什麼。
乾淨重播
我想要的另一個功能是能夠在需要時從乾淨狀態重現結果。
有時候變更會通過,是因為工作環境中留下了某些東西:產生的檔案、快取、本地狀態,或另一個未提交的變更。
乾淨重播有助於回答一個簡單的問題:
相同的結果是否能在不依賴目前工作目錄狀態的情況下被重現?
並非每個任務都需要完整的乾淨重播,但對於重現性很重要的變更,它能給審查者另一個有用的證據。
審查摘要
自動化的其中一個問題是它可能產生太多輸出。
原始日誌在調查某些事情時很有用,但它們並不總是審查變更的最佳方式。
這個工具會產生一個結構化的審查摘要,讓主要結果更容易檢查。
審查者可以看到以下項目:
Scope: PASS
Final verification: PASS
Broken baseline probe: FAIL
Fixed probe: PASS
Differential evidence: PASS
Replay: REPRODUCIBLE
Enter fullscreen mode
Exit fullscreen mode
如果有東西失敗,摘要應該清楚顯示,而不是隱藏在成功的最終指令後面。
這個想法是要減少審查者需要做的重建工作量。
證明包和完整性
工作流程也可以匯出證明材料並驗證其完整性。
當證據需要被移動、封存或稍後審查時,這很有用。
工作流程不僅僅說某個指令在某個時間點通過,它還能保留相關的結果記錄,並驗證預期的材料沒有改變。
這並不是要將工具變成安全認證系統。它只是一種讓每次執行的證據更易檢查和重現的方式。
READY_FOR_REVIEW 的意義
我想要保持非常清楚的一件事是最終狀態的意義。
當工具回報:
READY_FOR_REVIEW
Enter fullscreen mode
Exit fullscreen mode
它並不表示:
The code is definitely correct.
Enter fullscreen mode
Exit fullscreen mode
它也不表示:
The code is secure.
Enter fullscreen mode
Exit fullscreen mode
它同樣不表示:
This is automatically production-ready.
Enter fullscreen mode
Exit fullscreen mode
它的意思是設定的機械化證據閘門已通過,結果已準備好讓人類審查者檢查。
這個區別是故意的。
我不認為自動化工作流程應該默默地把機械化證據升級成語義化的工程判斷。
人類審查者仍然需要去看實際的變更,並決定它對系統來說是否正確。
為什麼這對程式碼代理來說更重要
人類開發者在進行變更時,通常腦中會有一些脈絡。他們知道自己碰了什麼、試圖修復什麼,以及他們做了什麼假設。
使用 AI 程式碼代理時,更多的工作可以自動且快速地發生。
這種速度很有用,但這也意味著更容易僅僅因為代理說任務完成且最終測試是綠燈就接受結果。
實作變得越快,就越有必要讓驗證流程變得明確。
我並不把這視為反對程式碼代理的論點。我有在使用它們。
重點是,如果代理要為我們進行更多變更,那麼圍繞這些變更的證據也應該變得更好。
以 Linux 為優先且本地化
工具的第一個版本在環境假設上刻意保持簡單。
它被設計用於 Linux,並使用本地工作流程,包含:
- Python 3.10+
- Git
- 一個本地的專案儲存庫
我希望第一個版本能保持專注,而不是宣稱支援我還沒有適當驗證的平台。
Windows 和 macOS 不是已驗證的 V1 環境的一部分。
這可能在之後會改變,但我寧願明確說明實際測試過的內容。
這個工具不是什麼
這個工具並不試圖證明一個程式是正確的。
它不會取代單元測試、整合測試、靜態分析、安全審查,或良好的人類程式碼審查。
它也不會自動讓弱測試變強。
如果迴歸探測設計不佳,工作流程可以偵測某些類型的弱證據,例如一個在壞掉和修復版本上都通過的探測,但它無法理解每個專案的每一個語義需求。
它所做的是提供一個圍繞現有證據的更嚴格流程。
對我來說,那就是有用的部分。
實際工作流程
一個典型流程大致看起來像這樣:
- 定義任務和允許的路徑。
- 為程式碼代理產生一個有邊界的簡報。
- 讓代理實作修復。
- 執行宣告的最終驗證。
- 檢查產生的變更是否符合允許的範圍。
- 對壞掉的基準執行相同的迴歸探測。
- 如果探測無法區分壞掉和修復,則拒絕該證據。
- 在需要時執行乾淨重播。
- 產生審查摘要。
- 如果需要,匯出並驗證證明材料。
- 將結果交給人類審查者。
它刻意不是一個完全自主的核准系統。
最後一步仍然是審查。
一個小例子
假設錯誤出在一個 slug 函數。
壞掉的實作是:
def slugify(text):
    return text.strip().lower().replace(" ", "")
Enter fullscreen mode
Exit fullscreen mode
對於這個輸入:
Hello World
Enter fullscreen mode
Exit fullscreen mode
壞掉的結果是:
helloworld
Enter fullscreen mode
Exit fullscreen mode
要求的結果是:
hello-world
Enter fullscreen mode
Exit fullscreen mode
修復可能是:
def slugify(text):
    return "-".join(text.lower().split())
Enter fullscreen mode
Exit fullscreen mode
而迴歸探測是:
def test_slugify():
    assert slugify("Hello World") == "hello-world"
    assert slugify("Two Words") == "two-words"
Enter fullscreen mode
Exit fullscreen mode
現在有用的部分不僅是這個測試在修復後通過。
更強的證據是:
Broken baseline: FAIL
Fixed result:    PASS
Enter fullscreen mode
Exit fullscreen mode
這告訴審查者,探測實際上偵測到了正在被修正的行為。
我為什麼建構它
主要原因是,我想要更多而不是更少地使用程式碼代理。
但如果我打算委派更多實作工作給它們,我想要在「代理說它完成了」和「有足夠證據讓我認真審查結果」之間有更好的界線。
這就是這個專案試圖填補的差距。
它仍然是第一個版本,我預期隨著我在更多專案上使用它並發現更多邊緣案例,工作流程會繼續演進。
目前,焦點很窄:有邊界的變更、更強的迴歸證據、重現性,以及人類審查。
如果這聽起來對你使用程式碼代理的方式有幫助,我已在這裡釋出第一個版本:
https://sovereign-system.itch.io/ai-coding-agent-reliability-kit
https://dev.to/rabeh_arch/why-green-tests-are-not-enough-for-ai-coding-agents-app
https://www.worldprogramming.org/posts/why-green-tests-are-not-enough-for-ai-coding-agents-h3x7u8
專案狀態 — 2026 年 10 月 22 日: 這是 Cognee 議題 #6222 的設計提案。維護者指派尚未確定。連接器尚未實作或測試,也還沒有 PR。本文說明提出的範圍與驗證計畫。
專案 wiki 所保存的不只是文件。它記錄了團隊為何選擇某種做法、哪個服務擁有某項責任,以及事件發生時的經過。一個有用的記憶整合應該保留這些筆記及其來源連結,同時也要忘記作者已刪除的內容。
在 Mergetober 期間,提出的貢獻是一個 TiddlyWiki 與 Cognee 之間的唯讀連接器。初始目標是 TiddlyWiki 的官方 Node.js 伺服器,選取的文字筆記會透過 Cognee 現有的 document-source 路徑被攝取為文件。
以小型專案 wiki 作為範例
規劃的示範使用一個專用的本地 wiki,包含關於服務所有權、部署決策和事件的合成筆記。它應該能支援以下問題:「誰擁有帳單?」以及「這個專案為什麼選擇目前的部署方式?」
接著會修改所有權筆記、執行另一次同步,並檢查更新後的答案。最後會刪除一則筆記,並確認過時資訊已被遺忘。這些是規劃的檢查項目,並非目前已取得的結果。
透過已記載的 API 讀取筆記
TiddlyWiki 提供了 筆記清單端點 與 單一筆記端點。連接器提案使用允許的預設清單功能,並在本機進行標題或標籤篩選。
每份文件應保留筆記標題、選取的標籤、文字內容,以及來源永久連結。第一版會排除系統/設定筆記與二進位附件。它會保留筆記文字,而不執行 wiki 巨集或追隨連結檔案。
讀取失敗不得視為刪除
提出的同步方式是所選筆記的完整快照。Cognee 可利用穩定的語意內容避免重新處理未變更的文件,而成功的快照則提供調和已刪除或重新命名筆記所需的清冊。
這也帶來一項責任:驗證失敗、格式錯誤的回應或筆記擷取失敗都必須中止執行。將部分擷取視為完整清冊,可能導致仍存在的內容被移除。
在清單與擷取之間消失的筆記需要有限次的重試或明確標記為失敗的執行。刪除最後一則筆記也需要真實的整合測試;僅通過 HTTP 單元測試無法確認圖譜清理是否正常運作。
送出 PR 前需收集的證據
| 檢查項目 | 目前狀態 |
|---|---|
| HTTP 驗證、標題編碼、標籤剖析與錯誤處理 | 已規劃 |
| 真實的 dlt 管線與 Cognee 文件攝取 | 已規劃 |
| 在 loopback 上執行的官方 TiddlyWiki 伺服器 | 已規劃 |
| 未變更的同步、編輯、重新命名、範圍變更與刪除 | 已規劃 |
| 最後一則筆記的刪除與失敗執行保留 | 已規劃 |
| 端到端搜尋答案與來源出處 | 已規劃 |
完成的逐步說明將包含已測試的套件版本、可重現的設定指令、實際的 PR 連結,以及觀察到的結果。模擬測試與即時服務檢查將另外報告。
範圍與協助
提案與指派請求 包含套件佈局與驗收計畫。實作正等待指派以及澄清 Mergetober 對 AI 協助的期望。
AI 揭露: 本提案與文章是依我的要求由 Codex 研究與起草。文章標記為 Fully Autonomous 以反映此作者身分。實作細節與測試結果將在對應工作完成後才會報告。
https://dev.to/saif_modan/tiddlywiki-x-cognee-a-design-proposal-for-searchable-project-notes-4cdo

精美的動畫預覽是很有用的靈感來源。要將它轉變成你自己的專案,你還需要提示詞、輸入內容,以及渲染設定。
我們的團隊維護了一個 Claude Opus 5.5 範例的視覺收藏。其中一個條目是由 @twoclipping 分享的循環 UI 動畫。所附的 GIF 是創作者成果的摘錄,並非我們團隊的重製。
這個提示詞一開始要求 8–12 個 UI 狀態、黑白調色盤或單一強調色,以及一段約 120 BPM 的免版稅音樂軌道。接著它描述了一個在這些狀態之間變形的連續形狀,而不是在不相關的畫面之間切換。
如果你要改編這個範例,請先決定那些輸入內容。一個按鈕、載入器、播放器、滑桿和圖表是好的起點;加入足夠的狀態以符合提示詞要求的範圍。然後閱讀完整的提示詞以了解製作限制,並在要求代理渲染之前提供其餘的輸入內容。
這就是我們希望這個函式庫能支援的瀏覽流程:檢查結果、閱讀公開的提示詞、確認設定,並加以改編。這個收藏橫跨七個類別,我們持續新增附有原始創作者連結的範例。

函式庫:https://github.com/LeaddeOpenLab/awesome-opus-5-5-video-prompts
原始範例與提示詞來源:https://x.com/twoclipping/status/2103273003555402193
我們並未獨立重製每一個條目。當你嘗試使用分享的創意程式設計提示詞時,通常會發現哪些設定資訊是缺失的?
披露:我協助維護這個收藏。本文是在 AI 協助下起草的。
OpenAI 的廣告收集器位於 bzr.openai.com,它設定了一個名為 __obi 的 cookie。此 cookie 的作用域限定在 .openai.com,其值是在你使用 ChatGPT 時寫入,並與你的 ChatGPT 帳戶綁定,之後會從你造訪的一般網站發送回 OpenAI。任何在 ChatGPT 上購買廣告的公司,都會在其自家網站安裝一段 OpenAI 程式碼,就像零售商早已執行 Meta 和 Google 的標籤一樣。當該程式碼載入時,__obi 就會連同你在該頁面上的行為一起傳送給 OpenAI:你搜尋的產品、閱讀的文章、購買行為。OpenAI 可以將所有這些解析回你的帳戶。
一位研究人員在 Android 手機上重現了完整的機制,使用兩種獨立的擷取方法進行確認,並與涵蓋 936 個廣告商像素、1,029 個主機名稱的數個月流量進行交叉比對。
三步驟同步機制
在 chatgpt.com 上,用戶端會產生 16 個隨機位元組,並呼叫 POST /backend-api/bazaar/obi/sync-token(或在你登出時使用 /backend-anon/)。後端會回傳一個 RS256 JWT,將帳戶 sub 與 obi 識別碼綁定,使用 aud: bzr.openai.com 將其限定在收集器,並在 60 秒後過期。該權杖還會帶有 purpose: obi_sync 和 consent_decision: analytics_allowed。(bzr 是 bazaar,即 OpenAI 內部對廣告平台的稱呼;發行服務則是 wadi。)
用戶端接著會將該權杖以跨站方式 POST 到 bzr.openai.com/v1/obi/sync,並得到以下回應:
Set-Cookie: __obi=...; Domain=.openai.com; HttpOnly;
            Max-Age=31536000; Path=/; SameSite=none; Secure
進入全螢幕模式
退出全螢幕模式
SameSite=None 搭配 Secure 正是 cookie 需要用來搭乘跨站請求的設定,而 Max-Age 為一年。JWT 中的 obi 值與 cookie 值完全相同。在廣告商頁面上觀察到的其他 OpenAI cookie 都被瀏覽器阻擋;__obi 是唯一以 SameSite=None 設定的 OpenAI 識別碼。
從那時起,廣告商網站就會將它回傳。在存放有 __obi 的手機上,從廣告商頁面發送到 OpenAI 主機的每個請求類別都帶有此 cookie。像素 SDK 有一條省略憑證的程式碼路徑,但這並沒有影響:瀏覽器會在任何 OpenAI 程式碼執行前,就將 cookie 附加到載入 SDK 的 <script src> 請求。載入標籤就會揭露此識別碼。
還有什麼會一起傳送
相同的 SDK 會從廣告商頁面抓取身分資訊。酬載會依來源標記四種來源:in 表示廣告商故意傳遞的值,而 fm、ht、js 則是從表單欄位、渲染的頁面文字和標籤管理器匯流排抓取的值。被抓取的身分資訊數量超過廣告商提供的身分資訊,685 個事件對 255 個事件。SDK 會用自己的函式取代 window.dataLayer.push,讀取 adobeDataLayer,並透過解析 gtm.js 標籤中的 l= 參數來尋找重新命名的 GTM 層。目前版本會從匯流排取得電子郵件和電話;0.1.31 版還會取得姓名和地理位置,直到 8 月 27 日範圍被縮小為止。
電子郵件、電話和姓名在傳輸前會經過 SHA-256 雜湊。國家、地區、城市和郵遞區號則以明文傳送,而郵遞區號是被收集最多的表單欄位,在 28 個網站上共 100 個事件。網址會被簡化為來源加上路徑,在 23,929 個觀察到的案例中沒有一個帶有查詢字串,但路徑會被保留,而到達收集器的路徑中包含醫療狀況、債務解決漏斗和訴訟受理表單。一個拒絕清單會丟棄密碼、一次性驗證碼、信用卡號、社安號、生日、病史、診斷和法庭欄位。在 881 個已知設定的像素中,有 638 個開啟了自動配對,包括樣本中所有的信用和貸款廣告商。
在測試裝置上,單一 __obi 值從 12 個商業網站以 13 個像素 ID 發送到 OpenAI,包括 Chewy、Wayfair、ThriftBooks、Eventbrite、HelloFresh、Coursera 和 SeatGeek,每個都以 202 狀態接受。在更廣泛的擷取中,30 個不同的 __obi 值中有 12 個出現在超過一個廣告商下,其中一個出現在十個廣告商下。
即使登出也會執行
在 932 個解碼的同步權杖中,有 736 個是 account_user,196 個是匿名,而匿名主體與帳戶主體一樣穩定:每個裝置一個值,至少持續 27 天。
OpenAI 的 cookie 政策將 __obi 列在「分析」類別下,有效期一年,而且它是該區段中唯一的項目;政策指出分析 cookie 幫助 OpenAI 了解其服務的表現。OpenAI 將同意分為 oai_consent_analytics 和 oai_consent_marketing,而每個解碼的同步權杖都帶有 analytics_allowed。允許分析但拒絕行銷的使用者仍然會收到此 cookie 和跨站解析。
研究人員在 9 月 14 日向 OpenAI 提出兩個問題:為什麼 __obi 被歸類為分析,以及拒絕行銷是否能阻止它。OpenAI 支援團隊確認收到詢問,表示會在內部分享這些觀察,但兩個問題都沒有回答。
如果你運行這些系統,這代表什麼
此機制是標準的廣告技術。Meta 幾年前就建立了結構上等同的系統:已登入的帳戶、像素觸發時的第三方 cookie、解析到個人檔案的站外轉換。在 AI 聊天產品上運行這套系統是新的,而且很重要,因為人們會告訴這些系統他們永遠不會發佈到社群網路的事情,而且這些系統越來越會為他們採取行動。
此行為是在 Android 版 Chrome 上觀察到的。Safari 的智慧追蹤預防會阻擋所有第三方 cookie,而 iOS 上的 Chrome 底層是 WebKit,因此沒有 iOS 瀏覽器會運行它;桌面版 Chrome 尚未測試。閘控相當寬鬆:大約每五個 ChatGPT 工作階段會產生一個同步權杖,而行動網頁用戶端在完全沒有同步的情況下就會投放廣告,因此你可能會看到沒有附加 cookie 的像素觸發。伺服器端的 join 並未直接觀察;202 狀態確認收集器接受了帶有 cookie 的事件,而解析到帳戶則來自於設計本身。
如果你經營其中一個廣告商網站,你無法看到任何這些情況。__obi 屬於你的腳本無法讀取的域名,因此你安裝了一個轉換像素,卻無法得知你的訪客正被解析到 ChatGPT 身分。該像素的另一個 cookie __obref,是以每個網站不同的值設定在你自己的域名上,並不會跨站:在觀察到的 2,860 個值中,有 2,828 個僅出現在一個廣告商下。
https://dev.to/randomchaos/chatgpt-already-knows-your-other-browsing-1poj
https://www.worldprogramming.org/posts/chatgpt-already-knows-your-other-browsing-avxaji

如果你曾經和 SQL 搏鬥過,這篇文章就是為你準備的。
AI 可以產生可執行的 SQL 語句,但它常常不太可靠。SQLazy 將 SQL 開發轉變成逐步、可驗證且可稽核的工作流程,並透過編譯器確保最終輸出正確。SQLazy 的運作方式?SQLazy 不會一次產生一大塊 SQL。而是將 SQL 開發轉變成逐步且可追蹤的工作流程:
- 使用半自然語言語法來描述每個步驟的作用。
- 在每個步驟驗證邏輯 – 中間結果可以檢查。
- 讓編譯器產生最終的 SQL。
希望能得到你的支持 — 每個讚和留言都很重要:
https://www.producthunt.com/products/sqlazy?utm_source=other&utm_medium=social
非常感謝。
https://dev.to/esproc_spl/sqlazy-is-live-on-product-hunt-today-2id0
https://www.worldprogramming.org/posts/sqlazy-is-live-on-product-hunt-today-suz5dh
每一個 Playwright 測試套件一開始都很乾淨。二十個測試全部綠燈,九十秒內跑完。然後它開始成長。
到了第五十個測試時,有人加入了 waitForTimeout 來「修復」競爭條件。到了第一百個測試時,測試套件大概每四次執行就會失敗一次——而且從來不是同一個測試失敗兩次。人們開始重新執行管線直到它變綠為止。到那個時候,測試套件已經不再是安全網,而是變成了稅負。
我看過這個現象在足夠多的專案上發生,注意到它幾乎總是由相同的五個原因造成。它們沒有一個是特別複雜的。它們如下,每一個都附上對應的修復方式。
1. waitForTimeout 不是等待,它是一場賭博
這是最大的一個。它在測試第一次出現間歇性失敗時就會出現,有人會伸手拿最快速的修復方式:
await page.click('#submit');
await page.waitForTimeout(2000);        // ← the bet
await expect(page.locator('.result')).toBeVisible();
Enter fullscreen mode
Exit fullscreen mode
這場賭博是假設兩秒鐘永遠都足夠。在你的筆電上是足夠的。在凌晨三點負載較重的 CI 執行器上有時就不夠了。而在那些確實足夠的日子裡,你仍然要付出兩秒鐘的代價——乘以一百個測試,你就為每次執行無謂地多增加了三分鐘。
修復方式:等待你真正需要的東西。
await page.click('#submit');
await expect(page.locator('.result')).toBeVisible();   // auto-waits, up to the timeout
Enter fullscreen mode
Exit fullscreen mode
Playwright 的斷言已經會自動重試直到通過或逾時。你幾乎不需要明確的等待。當你真的需要時——例如點擊觸發了一個 XHR,而你需要它的結果才能繼續——就等待那個特定的事情:
const response = page.waitForResponse(res => res.url().includes('/api/order'));
await page.click('#submit');
await response;
Enter fullscreen mode
Exit fullscreen mode
用 lint 來強制執行,而不是靠紀律。 紀律在截止期限壓力下會失效。加入 eslint-plugin-playwright 並將 no-wait-for-timeout 開啟為錯誤。現在管線會拒絕它,沒有人需要在審核時人工檢查。
2. 共用資料的測試在平行執行時會互相碰撞
這個很狡猾,因為它只有在你開啟平行執行後才會出現。
test('registers a new user', async ({ page }) => {
  await registerUser(page, '[email protected]', 'Password123!');
  await expect(page.locator('.welcome')).toBeVisible();
});
Enter fullscreen mode
Exit fullscreen mode
單獨執行時完美無缺。當你用兩個 worker 執行它,或是在沒有重置資料庫的情況下執行兩次,第二個就會碰到「email already registered」。這個失敗看起來像是註冊錯誤。其實不是。這是你的測試資料造成的。
修復方式:為每個測試產生唯一的資料,絕對不要硬編碼。
const user = {
  email: `qa.${randomUUID().split('-')[0]}@example.com`,
  password: 'Str0ng!Passw0rd',
};
Enter fullscreen mode
Exit fullscreen mode
寫一個小型的工廠模組是很值得的。而且——這聽起來過度,直到它幫你省了一天時間——為工廠本身撰寫單元測試。一個會默默產生重複資料的工廠會造成看起來完全像是應用程式錯誤的失敗,你會在錯誤的程式碼庫中花上好幾小時才懷疑到它。斷言「2000 個產生的 email 都是唯一的」只需要三十毫秒,並能消除這一整類的混亂。
3. 每個測試都重新登入一次
這不完全是不穩定,但它會讓其他問題更加惡化。如果每個測試一開始都要填寫登入表單,你就要為每個測試付出三到五秒,並給自己額外一百次機會在這個最常執行的流程上碰到計時失敗。
修復方式:登入一次,儲存 session,重複使用它。
建立一個設定專案:
// tests/auth.setup.ts
setup('authenticate', async ({ page }) => {
  await page.goto('/login');
  await page.getByLabel('Username').fill(process.env.TEST_USERNAME!);
  await page.getByLabel('Password').fill(process.env.TEST_PASSWORD!);
  await page.getByRole('button', { name: 'Login' }).click();

  await expect(page.getByRole('link', { name: 'Logout' })).toBeVisible();
  await page.context().storageState({ path: 'playwright/.auth/user.json' });
});
Enter fullscreen mode
Exit fullscreen mode
將它設定為相依性:
projects: [
  { name: 'setup', testMatch: /.*.setup.ts/ },
  {
    name: 'chromium',
    use: { ...devices['Desktop Chrome'], storageState: 'playwright/.auth/user.json' },
    dependencies: ['setup'],
  },
]
Enter fullscreen mode
Exit fullscreen mode
在一個 200 個測試的套件中,這通常能為每次執行減少好幾分鐘。它通常是可取得的最大單一速度改善。
有一個細節很重要:讓設定專案大聲斷言登入確實成功。如果它默默失敗,每個下游測試都會以令人困惑的方式失敗,而你會去除錯錯誤的東西。
4. 綁定在標記而不是意義上的 Locator
await page.click('.btn-primary.submit-form > span:nth-child(2)');
Enter fullscreen mode
Exit fullscreen mode
這個今天能通過,但在下一次有開發者把東西包在 div 裡時就會壞掉。更糟糕的是,它會「默默」壞掉,因為失敗訊息完全沒有告訴你實際上發生了什麼改變。
修復方式:根據使用者感知的東西來定位。
await page.getByRole('button', { name: 'Submit order' }).click();
Enter fullscreen mode
Exit fullscreen mode
這個優先順序很穩固:
-
getByRole—— 能承受重新設計,符合使用者和螢幕閱讀器看到的內容 -
getByLabel—— 將欄位與其可存取標籤繫結 -
getByTestId—— 當標記沒有提供任何語義資訊時 - CSS/XPath —— 最後手段
還有一個值得一提的額外好處:如果 getByRole 和 getByLabel 找不到你的元素,這通常代表應用程式中存在真正的無障礙問題。你的測試套件開始免費兼作無障礙冒煙測試。
5. 在所有東西上都失敗的視覺測試
團隊加入視覺回歸測試,在每個不相關的變更上都得到失敗,然後在一個月內就把它關掉。有三個原因:
動畫。 在轉場中間拍的截圖永遠不會符合。全局停用它們:
expect: {
  toHaveScreenshot: { animations: 'disabled', maxDiffPixelRatio: 0.02 },
}
Enter fullscreen mode
Exit fullscreen mode
不同機器上的字型渲染。 macOS 和 Linux 的抗鋸齒方式不同,所以在本機產生的基準永遠不會與 CI 相符。要嘛在 Docker 內產生基準,讓每個人都與相同的渲染比較;或者保留一個小的像素容忍度。
真正動態的內容。 時間戳、頭像、廣告欄位。遮罩它們:
await expect(page).toHaveScreenshot('dashboard.png', {
  mask: [page.locator('time'), page.locator('.ad-slot')],
});
Enter fullscreen mode
Exit fullscreen mode
並且優先選擇元件層級的快照,而不是全頁面的。全頁面基準在任何地方有任何改變時都會失敗。只有結帳表單的快照只會在結帳表單改變時失敗——這才是你真正想要的訊號。
這五個問題底層的模式
這五個問題的每一個都是同樣的錯誤,只是穿著不同的衣服:將關於時機或狀態的假設編碼進去,而不是等待真正的事情發生。
固定的延遲假設了時機。硬編碼的 email 假設沒有人同時在執行。CSS 路徑 locator 假設了 DOM 的形狀。全頁面快照假設頁面上沒有其他東西會改變。
用實際的條件取代每個假設,不穩定就會消失。不是「大部分消失」——而是完全消失。不穩定的測試套件並不是瀏覽器測試的固有特性,它們是建立在假設上的測試套件的特性。
一個實際的修復順序
如果你繼承了一個不穩定的測試套件,不要重寫它。依照這個順序進行——先做最便宜且影響最大的:
-
加入 lint 規則 讓它幫你找出每一個
waitForTimeout - 加入認證快取 —— 最大的速度改善,只碰一個檔案
- 修復前三個最不穩定的測試 —— 你的 CI 歷史知道它們是哪些
- 在你碰到每個檔案時替換脆弱的 locator,而不是一次大掃除
- 當你下次碰到碰撞時加入資料產生機制
你通常從前兩項就能得到大部分的好處。
我把這些模式——加上 API 測試、CI 分片和 Docker 設定——打包成一個 Playwright 入門套件,因為我每次專案都在重複建立同樣的東西。但這篇文章裡的所有內容都可以獨立使用;它們都不需要購買任何東西。