開始使用 Supabase .NET SDK
Supabase .NET SDK 是您 Supabase 專案的 C# 用戶端。
它透過單一 API 提供 Auth、Database、Storage、Realtime 和 Edge Functions,並處理與 Supabase 平台的通訊。
版本 8.0.0 已發佈,同時也推出了新的 Supabase.Extensions.DependencyInjection 套件。
本文將說明如何設定用戶端,並逐步介紹基本操作。
如果您是從先前的主要版本升級,有些部分已有所變動。
您不需要了解所有細節就能跟隨本教學,但值得知道以下事項:
- 序列化已從 Newtonsoft.Json 移至
System.Text.Json。自訂轉換器與[JsonProperty]屬性需改用System.Text.Json的對應功能。 - 每個服務用戶端現在都接受可注入的
HttpClient,並支援選擇性啟用重試與退避機制。 - 新增了適用於 ASP.NET Core 的相依性注入套件,下方會詳細說明。
- 套件目標為 .NET Standard 2.1。這表示不再支援 .NET Framework(其最高支援 .NET Standard 2.0),因此您需要 .NET Core 3.0+ 或 .NET 5+。
如果您想查看完整的變更清單,請查閱 發行說明。
遷移指南 列出了您可能遇到的所有重大變更以及處理方式。
將 meta-package 新增至您的專案。
它會引入所有五個服務套件(Auth、Postgrest、Storage、Realtime 和 Functions):
_10
dotnet add package Supabase
如果您只需要其中一個服務,請直接參考該套件,例如 Supabase.Gotrue 用於 Auth,或 Supabase.Postgrest 用於資料庫。
SDK 會將資料表對應至 C# 類別。
模型繼承自 BaseModel,並使用屬性將其屬性與欄位連結。
以下是我們將在後續範例中使用的 todos 資料表,包含 id、task 和 is_complete:
_15
using Supabase.Postgrest.Attributes;
_15
using Supabase.Postgrest.Models;
_15
_15
[Table("todos")]
_15
public class Todo : BaseModel
_15
{
_15
[PrimaryKey("id")]
_15
public int Id { get; set; }
_15
_15
[Column("task")]
_15
public string Task { get; set; }
_15
_15
[Column("is_complete")]
_15
public bool IsComplete { get; set; }
_15
}
ASP.NET Core#
安裝相依性注入套件:
_10
dotnet add package Supabase.Extensions.DependencyInjection
在 Program.cs 中註冊用戶端:
_14
using Supabase.Core.Http;
_14
using Supabase.Extensions.DependencyInjection;
_14
_14
var builder = WebApplication.CreateBuilder(args);
_14
builder.Services.AddSupabase(
_14
supabaseUrl: builder.Configuration["Supabase:Url"]!,
_14
supabaseKey: builder.Configuration["Supabase:Key"]!,
_14
configureOptions: options =>
_14
{
_14
options.AutoConnectRealtime = true;
_14
options.PostgrestRetry = new RetryOptions { MaxRetries = 3 };
_14
});
_14
_14
var app = builder.Build();
AddSupabase 會將 Supabase.Client 註冊為 scoped 服務,因此您可以在需要的地方注入它:minimal API endpoint、controller 或您自己的服務。
_13
using Supabase;
_13
_13
public class TodoService(Client supabase)
_13
{
_13
public async Task<List<Todo>> GetOpen()
_13
{
_13
var result = await supabase
_13
.From<Todo>()
_13
.Where(t => t.IsComplete == false)
_13
.Get();
_13
return result.Models;
_13
}
_13
}
它也會分別註冊每個子用戶端(IPostgrestClient、IGotrueClient<User, Session>、IStorageClient<Bucket, FileObject>、IFunctionsClient、IRealtimeClient<RealtimeSocket, RealtimeChannel>),因此只需碰觸單一服務的類別就能只依賴該服務。
我們建置這個擴充套件,讓您能輕鬆設定用戶端,而無需自己手動連接。
Supabase.Client 在建構時會自行建立 HttpClient。如果您以 scoped 或 transient 方式註冊,每次解析都會建立新的 HttpClient(以及新的 socket),在負載下會耗盡連線池。
AddSupabase 透過 IHttpClientFactory 來連接用戶端,讓處理程式能被共用與重用。
為了保持一致性,它會取代您透過 configureOptions 傳入的任何 HttpClient;您的 proxy、重試、Realtime 與其他選項仍然有效。
其他應用程式#
在 ASP.NET Core 之外的 Console 應用程式、Desktop、Mobile 或 Unity 中,請自行建構用戶端並只初始化一次:
_13
using Supabase;
_13
_13
var url = Environment.GetEnvironmentVariable("SUPABASE_URL")!;
_13
var key = Environment.GetEnvironmentVariable("SUPABASE_KEY")!;
_13
_13
var options = new SupabaseOptions
_13
{
_13
AutoRefreshToken = true,
_13
AutoConnectRealtime = true,
_13
};
_13
_13
var supabase = new Client(url, key, options);
_13
await supabase.InitializeAsync();
InitializeAsync 會還原已儲存的工作階段,並在開啟 AutoConnectRealtime 時建立 Realtime 連線。
預設的工作階段處理程式不會儲存任何資料,因此若要在重新啟動後還原登入,請將 SupabaseOptions.SessionHandler 設定為您自己實作的版本,用來儲存與載入工作階段。
請只建立一次用戶端並在應用程式中重複使用。
每次操作都建立新用戶端意味著每次都會建立新的 HttpClient,這與 DI 套件在伺服器上解決的問題相同。
以下範例會使用 supabase 變數,它是一個 Supabase.Client 實例。
查詢資料列#
From<T>() 會針對 T 所對應的資料表開啟查詢。
您可以使用 Where 進行篩選,然後呼叫 Get 來執行查詢。
Get 會回傳 ModeledResponse<T>,您可以在 Models 中找到資料列:
_10
ModeledResponse<Todo> result = await supabase
_10
.From<Todo>()
_10
.Where(t => t.IsComplete == false)
_10
.Get();
_10
List<Todo> todos = result.Models;
插入#
Insert 可以寫入單一模型或清單:
_10
await supabase.From<Todo>().Insert(new Todo { Task = "Write the launch notes", IsComplete = false });
更新與刪除#
更新實體有兩種方式,兩者都有效。
這取決於您是否已取得該資料列。
如果您已經取得模型,請修改其屬性並呼叫 Update。
從 Get 回傳的資料列會帶有自己的識別資訊,因此它知道要寫入哪一筆記錄:
_10
var result = await supabase.From<Todo>().Where(t => t.Id == 1).Get();
_10
var todo = result.Models.First();
_10
_10
todo.IsComplete = true;
_10
await todo.Update<Todo>();
_10
_10
await todo.Delete<Todo>();
如果您沒有模型,可以使用查詢建置器,這能省去一次 Get 查詢。
設定新的值、篩選資料列,然後執行:
_10
await supabase
_10
.From<Todo>()
_10
.Set(t => t.IsComplete, true)
_10
.Where(t => t.IsComplete == false)
_10
.Update();
_10
_10
await supabase
_10
.From<Todo>()
_10
.Where(t => t.IsComplete == true)
_10
.Delete();
雖然這看起來與 Entity Framework 的建置方式非常相似,但行為並不相同。
這裡沒有DbContext、沒有變更追蹤器,也沒有SaveChanges。
修改模型的屬性不會有任何作用,直到您呼叫Update,而且每次呼叫都是獨立的 HTTP 請求。
驗證使用者#
驗證功能位於 supabase.Auth。
使用電子郵件與密碼註冊並登入使用者:
_10
await supabase.Auth.SignUp("[email protected]", "a-secure-password");
_10
_10
var session = await supabase.Auth.SignIn("[email protected]", "a-secure-password");
當 AutoRefreshToken 啟用時,用戶端會在存取權杖到期前自動重新整理,並將其附加至您的資料庫與 Storage 呼叫,因此 Row-Level-Security 會套用至已登入的使用者。
相同的 supabase.Auth 介面也涵蓋 OAuth、magic links、電話與 SSO。
上傳檔案#
_10
await supabase.Storage
_10
.From("avatars")
_10
.Upload("./local/photo.png", "maria/photo.png");
版本 8.0.0 新增了可發佈的金鑰與秘密 API 金鑰,與現有的 anon 和 service 金鑰並存。
在任何會發佈給使用者的應用程式中使用可發佈金鑰或 anon 金鑰。
請將 secret 和 service 金鑰保留在伺服器上。
Service 金鑰會繞過 Row Level Security,因此不應放在用戶端應用程式中。
當您需要此等級的存取權時,請為其使用獨立的用戶端。
您現在已設定好用戶端,可以從 .NET 執行查詢、驗證與 Storage 操作。接下來您可以:
- 瀏覽 C# 參考文件 以取得完整 API。
- 閱讀 DependencyInjection 套件 README 以了解 ASP.NET Core 的詳細資訊。
- 查看 SDK 存放庫 以取得範例與更新日誌。
https://supabase.com/blog/getting-started-with-the-supabase-dotnet-sdk
https://www.worldprogramming.org/posts/getting-started-with-the-supabase-net-sdk-gquayn
過去幾個月,我花了更多時間與 AI 程式碼代理合作。它們速度快、實用,而且在許多情況下,它們能比手動操作更快地修復小錯誤或實作特定變更。
但在使用它們的過程中,我一直回到同一個問題:我如何知道圍繞修復的證據是否真的有意義?
很容易要求代理修改一些程式碼、執行測試,然後回傳綠燈結果。問題在於綠燈測試只告訴我最終版本通過了。它並不一定能告訴我該測試是否能夠偵測到原始的錯誤。
這個差異聽起來很小,但它非常重要。
想像一個 AI 代理修復了一個錯誤並新增了一個迴歸測試。最終測試執行通過,所以變更看起來不錯。現在想像我們拿完全相同的測試去對壞掉的程式碼版本執行,它在那裡也通過了。
在這種情況下,測試是綠燈的,但它並沒有真正證明錯誤已被修復。
這就是我想要更系統化處理的那種問題。
基本概念
原則很簡單:
壞掉的基準 + 迴歸探測 = 失敗
修復的結果 + 相同的迴歸探測 = 通過
如果相同的探測在壞掉的版本上失敗,而在修復的版本上通過,證據就會強得多。
如果它在兩個版本上都通過,那麼測試可能並沒有真正測試我們關心的錯誤。
這個想法成為我一直在建構的一個小型工具的基礎,叫做 AI Coding Agent Reliability Kit。
它是一個以 Linux 為優先的本地工作流程,用來以更強的機械化證據審查 AI 輔助的錯誤修復。
目標不是取代程式碼審查、安全審查或工程判斷。目標是讓圍繞 AI 生成修復所產生的證據更容易檢查且更難被誤解。
我希望從工作流程中獲得什麼
當我開始研究這個時,我不想要另一個只是執行指令並印出成功或失敗的包裝工具。
我想要一個能回答關於變更幾個問題的工作流程。
代理被允許修改什麼?
它是否停留在該範圍內?
最終驗證指令是否真的通過?
迴歸探測是否在壞掉的基準上失敗?
結果是否能在乾淨的重播中重現?
另一個人是否能在不需手動重建一切的情況下審查證據?
這些是基本問題,但一旦程式碼代理開始進行更大或更頻繁的變更,它們就會變得重要。
在代理開始前界定變更範圍
這個工具所做的事情之一,是在程式碼工作開始前定義任務和允許的路徑。
這很有用,因為代理有時能在修復請求問題的同時也修改不相關的檔案。最終結果可能仍然能運作,但變更範圍會變得比必要的大。
對於一個聚焦的錯誤修復,我通常想要一個清楚的邊界。
例如,如果任務只需要在一個來源檔案和一個迴歸測試中進行變更,那麼對不相關的 README、設定檔或其他套件的修改應該立即可見。
這個工具會追蹤宣告的範圍,並檢查最終變更是否停留在其中。
如果有東西在允許的邊界之外被改變,則會被回報,而不是默默接受結果。
只檢查最終結果是不夠的
一般的工作流程通常在類似以下的情況後結束:
pytest tests/test_bug.py
Enter fullscreen mode
Exit fullscreen mode
指令成功退出,所以任務被視為完成。
這很有用,但對於迴歸修復,我想要多一項資訊。
我想要知道當相同的探測對已知的壞掉基準執行時會發生什麼。
一個好的迴歸探測通常應該能區分這兩個狀態。
例如:
Broken version: FAIL
Fixed version:  PASS
Enter fullscreen mode
Exit fullscreen mode
這是比以下情況強得多的訊號:
Broken version: PASS
Fixed version:  PASS
Enter fullscreen mode
Exit fullscreen mode
第二個結果並不一定表示程式碼有錯。它表示證據很弱。
這個區別很重要。
工作流程不應該假裝一個測試證明了它並沒有證明的事情。
非區分性測試
這是我建構這個工具的主要原因之一。
一個測試看起來可能完全有效,卻仍然無法區分壞掉和修復的版本。
例如,想像一個函數應該要將兩個數字相乘,但目前卻是相加。
壞掉的程式碼可能看起來像這樣:
def calculate(a, b):
    return a + b
Enter fullscreen mode
Exit fullscreen mode
修復將它改成:
def calculate(a, b):
    return a * b
Enter fullscreen mode
Exit fullscreen mode
現在想像測試只檢查這個:
def test_calculate_exists():
    assert callable(calculate)
Enter fullscreen mode
Exit fullscreen mode
這個測試在修復後是綠燈的,但它在修復前也是綠燈的。
它證明了函數存在。它並沒有證明錯誤已被修復。
這種結果不應該被視為與真正的迴歸測試相同。
這個工具會偵測這種情況,並將證據回報為非區分性,而不是將最終的綠燈結果視為足夠。
範圍違規
我想要處理的另一種情況是,實際的程式碼變更是正確的,但允許範圍之外的東西被修改了。
這可能意外發生,或是因為自動化工作流程在執行期間碰觸到另一個檔案。
假設代理被允許修改:
src/formatter.py
tests/test_formatter.py
Enter fullscreen mode
Exit fullscreen mode
來源修復和測試可能都是正確的,但如果最終變更也修改了:
README.md
Enter fullscreen mode
Exit fullscreen mode
那麼工作流程應該另外回報這一點。
這裡的重要觀點是,正確性和範圍是不同的事情。
一個正確的來源修復並不會自動讓不相關的變更變得可接受。
這個工具會將這些關注點分開,讓審查者能清楚看到到底發生了什麼。
乾淨重播
我想要的另一個功能是能夠在需要時從乾淨狀態重現結果。
有時候變更會通過,是因為工作環境中留下了某些東西:產生的檔案、快取、本地狀態,或另一個未提交的變更。
乾淨重播有助於回答一個簡單的問題:
相同的結果是否能在不依賴目前工作目錄狀態的情況下被重現?
並非每個任務都需要完整的乾淨重播,但對於重現性很重要的變更,它能給審查者另一個有用的證據。
審查摘要
自動化的其中一個問題是它可能產生太多輸出。
原始日誌在調查某些事情時很有用,但它們並不總是審查變更的最佳方式。
這個工具會產生一個結構化的審查摘要,讓主要結果更容易檢查。
審查者可以看到以下項目:
Scope: PASS
Final verification: PASS
Broken baseline probe: FAIL
Fixed probe: PASS
Differential evidence: PASS
Replay: REPRODUCIBLE
Enter fullscreen mode
Exit fullscreen mode
如果有東西失敗,摘要應該清楚顯示,而不是隱藏在成功的最終指令後面。
這個想法是要減少審查者需要做的重建工作量。
證明包和完整性
工作流程也可以匯出證明材料並驗證其完整性。
當證據需要被移動、封存或稍後審查時,這很有用。
工作流程不僅僅說某個指令在某個時間點通過,它還能保留相關的結果記錄,並驗證預期的材料沒有改變。
這並不是要將工具變成安全認證系統。它只是一種讓每次執行的證據更易檢查和重現的方式。
READY_FOR_REVIEW 的意義
我想要保持非常清楚的一件事是最終狀態的意義。
當工具回報:
READY_FOR_REVIEW
Enter fullscreen mode
Exit fullscreen mode
它並不表示:
The code is definitely correct.
Enter fullscreen mode
Exit fullscreen mode
它也不表示:
The code is secure.
Enter fullscreen mode
Exit fullscreen mode
它同樣不表示:
This is automatically production-ready.
Enter fullscreen mode
Exit fullscreen mode
它的意思是設定的機械化證據閘門已通過,結果已準備好讓人類審查者檢查。
這個區別是故意的。
我不認為自動化工作流程應該默默地把機械化證據升級成語義化的工程判斷。
人類審查者仍然需要去看實際的變更,並決定它對系統來說是否正確。
為什麼這對程式碼代理來說更重要
人類開發者在進行變更時,通常腦中會有一些脈絡。他們知道自己碰了什麼、試圖修復什麼,以及他們做了什麼假設。
使用 AI 程式碼代理時,更多的工作可以自動且快速地發生。
這種速度很有用,但這也意味著更容易僅僅因為代理說任務完成且最終測試是綠燈就接受結果。
實作變得越快,就越有必要讓驗證流程變得明確。
我並不把這視為反對程式碼代理的論點。我有在使用它們。
重點是,如果代理要為我們進行更多變更,那麼圍繞這些變更的證據也應該變得更好。
以 Linux 為優先且本地化
工具的第一個版本在環境假設上刻意保持簡單。
它被設計用於 Linux,並使用本地工作流程,包含:
- Python 3.10+
- Git
- 一個本地的專案儲存庫
我希望第一個版本能保持專注,而不是宣稱支援我還沒有適當驗證的平台。
Windows 和 macOS 不是已驗證的 V1 環境的一部分。
這可能在之後會改變,但我寧願明確說明實際測試過的內容。
這個工具不是什麼
這個工具並不試圖證明一個程式是正確的。
它不會取代單元測試、整合測試、靜態分析、安全審查,或良好的人類程式碼審查。
它也不會自動讓弱測試變強。
如果迴歸探測設計不佳,工作流程可以偵測某些類型的弱證據,例如一個在壞掉和修復版本上都通過的探測,但它無法理解每個專案的每一個語義需求。
它所做的是提供一個圍繞現有證據的更嚴格流程。
對我來說,那就是有用的部分。
實際工作流程
一個典型流程大致看起來像這樣:
- 定義任務和允許的路徑。
- 為程式碼代理產生一個有邊界的簡報。
- 讓代理實作修復。
- 執行宣告的最終驗證。
- 檢查產生的變更是否符合允許的範圍。
- 對壞掉的基準執行相同的迴歸探測。
- 如果探測無法區分壞掉和修復,則拒絕該證據。
- 在需要時執行乾淨重播。
- 產生審查摘要。
- 如果需要,匯出並驗證證明材料。
- 將結果交給人類審查者。
它刻意不是一個完全自主的核准系統。
最後一步仍然是審查。
一個小例子
假設錯誤出在一個 slug 函數。
壞掉的實作是:
def slugify(text):
    return text.strip().lower().replace(" ", "")
Enter fullscreen mode
Exit fullscreen mode
對於這個輸入:
Hello World
Enter fullscreen mode
Exit fullscreen mode
壞掉的結果是:
helloworld
Enter fullscreen mode
Exit fullscreen mode
要求的結果是:
hello-world
Enter fullscreen mode
Exit fullscreen mode
修復可能是:
def slugify(text):
    return "-".join(text.lower().split())
Enter fullscreen mode
Exit fullscreen mode
而迴歸探測是:
def test_slugify():
    assert slugify("Hello World") == "hello-world"
    assert slugify("Two Words") == "two-words"
Enter fullscreen mode
Exit fullscreen mode
現在有用的部分不僅是這個測試在修復後通過。
更強的證據是:
Broken baseline: FAIL
Fixed result:    PASS
Enter fullscreen mode
Exit fullscreen mode
這告訴審查者,探測實際上偵測到了正在被修正的行為。
我為什麼建構它
主要原因是,我想要更多而不是更少地使用程式碼代理。
但如果我打算委派更多實作工作給它們,我想要在「代理說它完成了」和「有足夠證據讓我認真審查結果」之間有更好的界線。
這就是這個專案試圖填補的差距。
它仍然是第一個版本,我預期隨著我在更多專案上使用它並發現更多邊緣案例,工作流程會繼續演進。
目前,焦點很窄:有邊界的變更、更強的迴歸證據、重現性,以及人類審查。
如果這聽起來對你使用程式碼代理的方式有幫助,我已在這裡釋出第一個版本:
https://sovereign-system.itch.io/ai-coding-agent-reliability-kit
https://dev.to/rabeh_arch/why-green-tests-are-not-enough-for-ai-coding-agents-app
https://www.worldprogramming.org/posts/why-green-tests-are-not-enough-for-ai-coding-agents-h3x7u8
專案狀態 — 2026 年 10 月 22 日: 這是 Cognee 議題 #6222 的設計提案。維護者指派尚未確定。連接器尚未實作或測試,也還沒有 PR。本文說明提出的範圍與驗證計畫。
專案 wiki 所保存的不只是文件。它記錄了團隊為何選擇某種做法、哪個服務擁有某項責任,以及事件發生時的經過。一個有用的記憶整合應該保留這些筆記及其來源連結,同時也要忘記作者已刪除的內容。
在 Mergetober 期間,提出的貢獻是一個 TiddlyWiki 與 Cognee 之間的唯讀連接器。初始目標是 TiddlyWiki 的官方 Node.js 伺服器,選取的文字筆記會透過 Cognee 現有的 document-source 路徑被攝取為文件。
以小型專案 wiki 作為範例
規劃的示範使用一個專用的本地 wiki,包含關於服務所有權、部署決策和事件的合成筆記。它應該能支援以下問題:「誰擁有帳單?」以及「這個專案為什麼選擇目前的部署方式?」
接著會修改所有權筆記、執行另一次同步,並檢查更新後的答案。最後會刪除一則筆記,並確認過時資訊已被遺忘。這些是規劃的檢查項目,並非目前已取得的結果。
透過已記載的 API 讀取筆記
TiddlyWiki 提供了 筆記清單端點 與 單一筆記端點。連接器提案使用允許的預設清單功能,並在本機進行標題或標籤篩選。
每份文件應保留筆記標題、選取的標籤、文字內容,以及來源永久連結。第一版會排除系統/設定筆記與二進位附件。它會保留筆記文字,而不執行 wiki 巨集或追隨連結檔案。
讀取失敗不得視為刪除
提出的同步方式是所選筆記的完整快照。Cognee 可利用穩定的語意內容避免重新處理未變更的文件,而成功的快照則提供調和已刪除或重新命名筆記所需的清冊。
這也帶來一項責任:驗證失敗、格式錯誤的回應或筆記擷取失敗都必須中止執行。將部分擷取視為完整清冊,可能導致仍存在的內容被移除。
在清單與擷取之間消失的筆記需要有限次的重試或明確標記為失敗的執行。刪除最後一則筆記也需要真實的整合測試;僅通過 HTTP 單元測試無法確認圖譜清理是否正常運作。
送出 PR 前需收集的證據
| 檢查項目 | 目前狀態 |
|---|---|
| HTTP 驗證、標題編碼、標籤剖析與錯誤處理 | 已規劃 |
| 真實的 dlt 管線與 Cognee 文件攝取 | 已規劃 |
| 在 loopback 上執行的官方 TiddlyWiki 伺服器 | 已規劃 |
| 未變更的同步、編輯、重新命名、範圍變更與刪除 | 已規劃 |
| 最後一則筆記的刪除與失敗執行保留 | 已規劃 |
| 端到端搜尋答案與來源出處 | 已規劃 |
完成的逐步說明將包含已測試的套件版本、可重現的設定指令、實際的 PR 連結,以及觀察到的結果。模擬測試與即時服務檢查將另外報告。
範圍與協助
提案與指派請求 包含套件佈局與驗收計畫。實作正等待指派以及澄清 Mergetober 對 AI 協助的期望。
AI 揭露: 本提案與文章是依我的要求由 Codex 研究與起草。文章標記為 Fully Autonomous 以反映此作者身分。實作細節與測試結果將在對應工作完成後才會報告。
https://dev.to/saif_modan/tiddlywiki-x-cognee-a-design-proposal-for-searchable-project-notes-4cdo
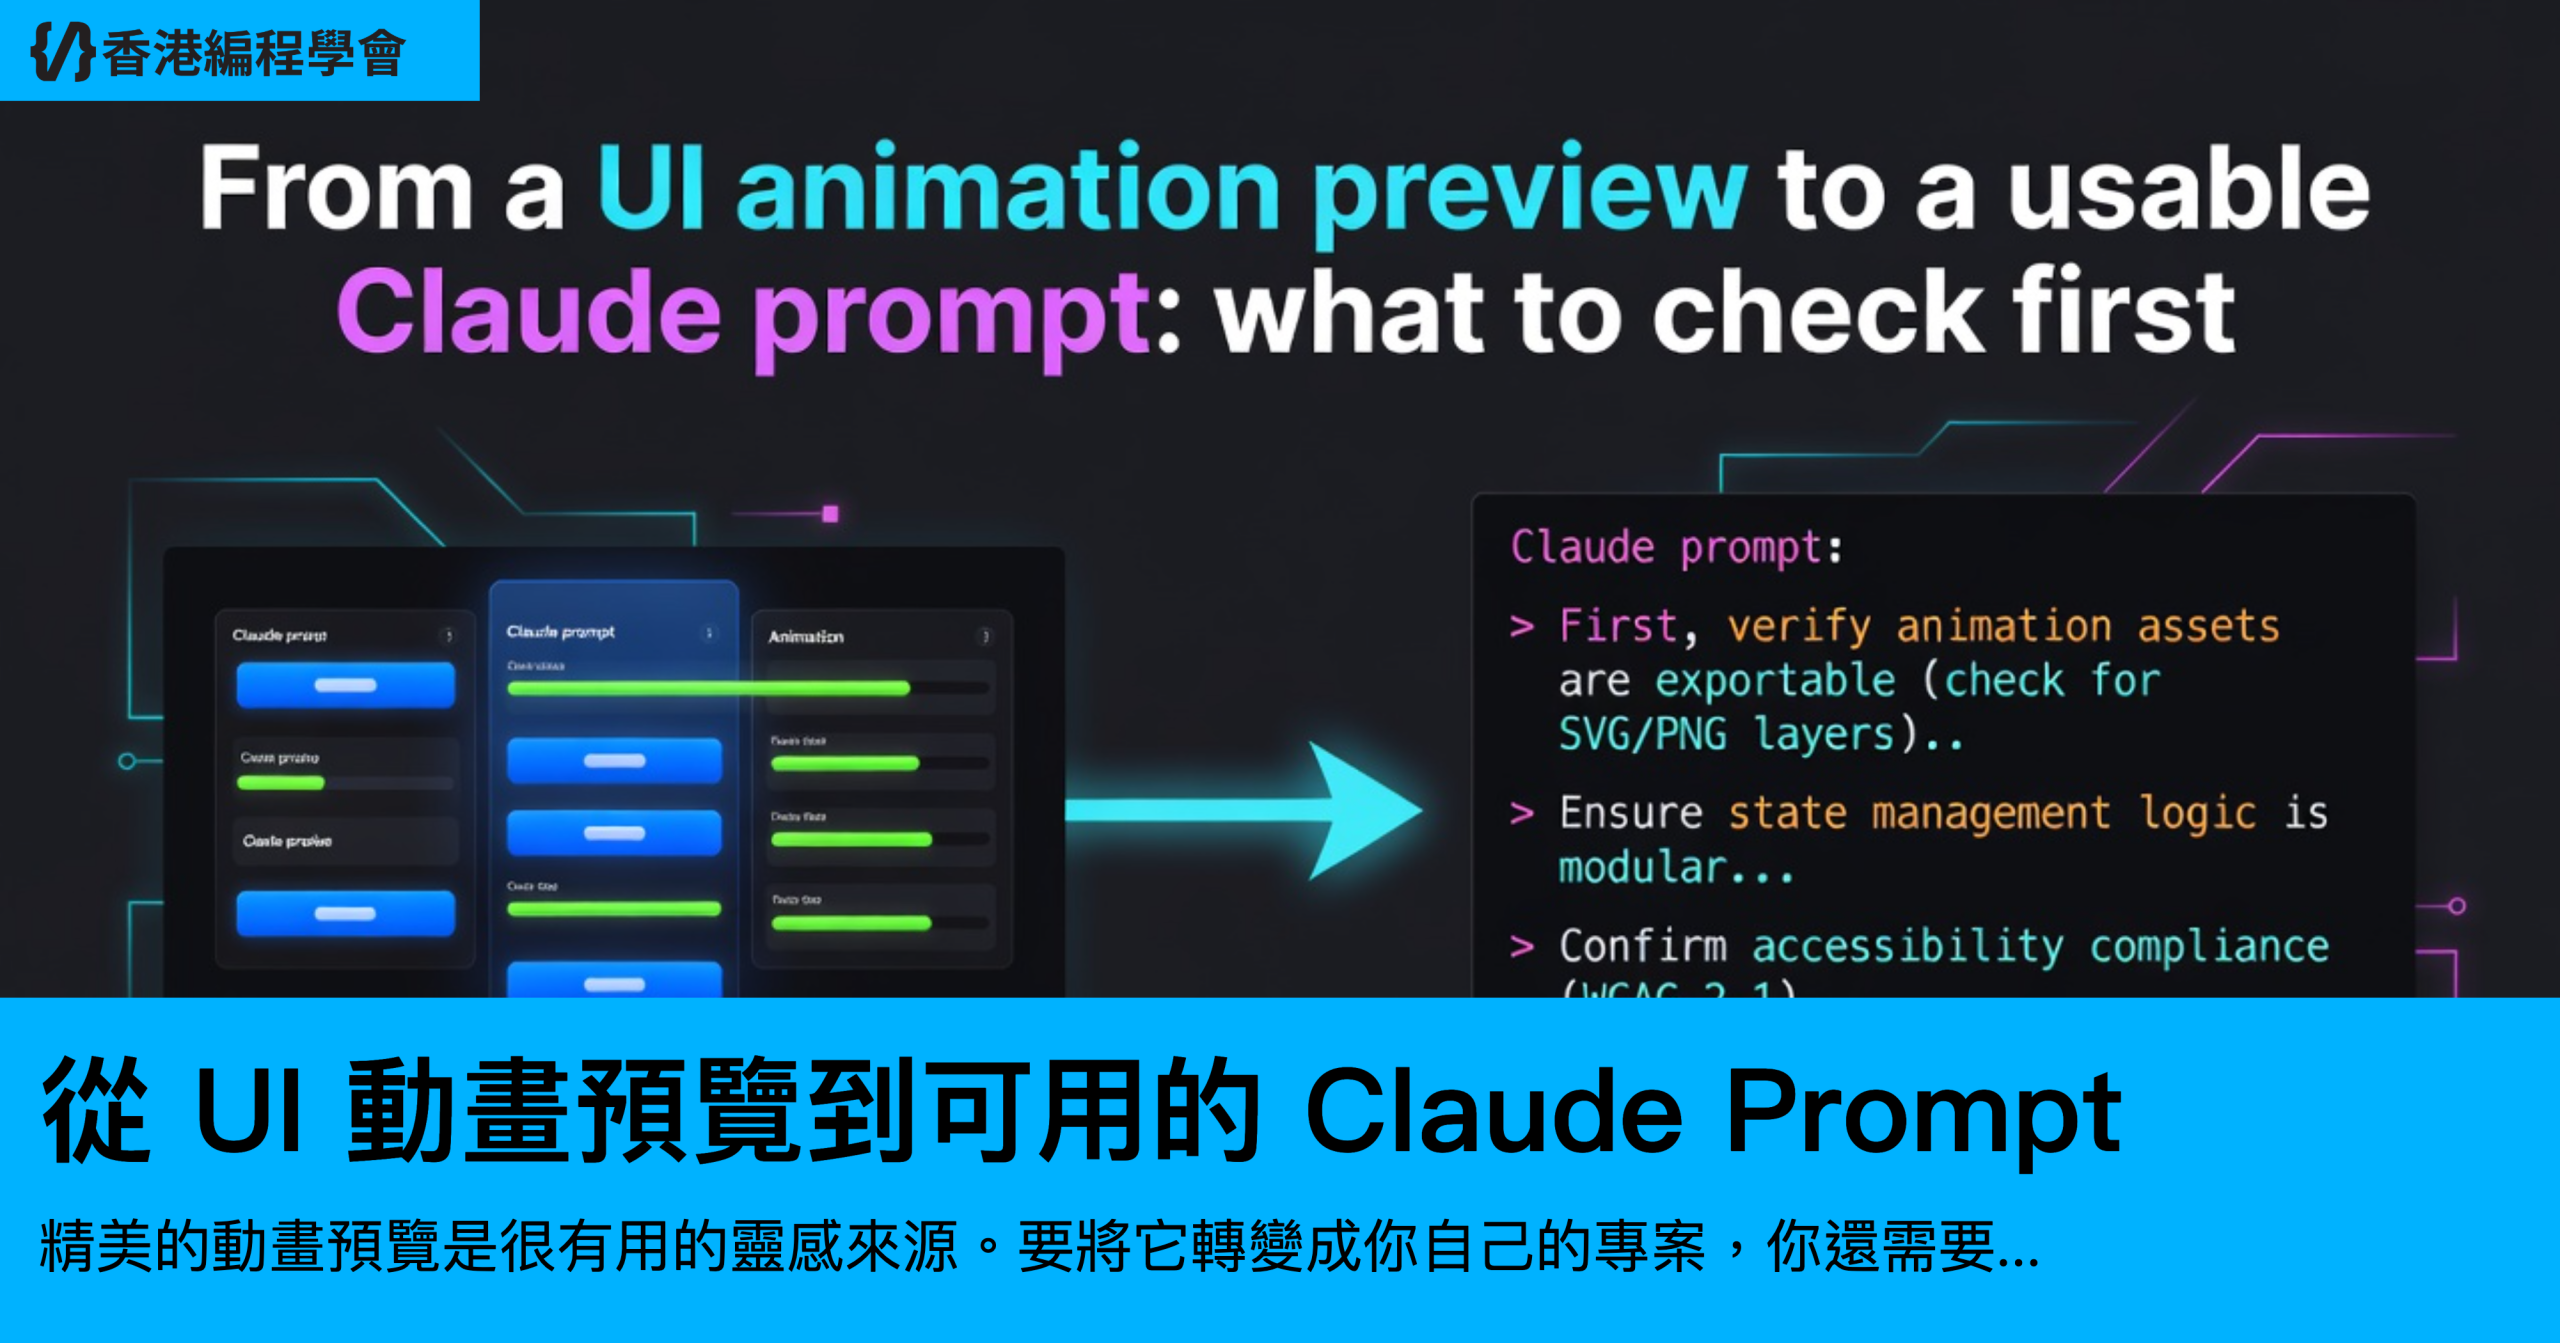

精美的動畫預覽是很有用的靈感來源。要將它轉變成你自己的專案,你還需要提示詞、輸入內容,以及渲染設定。
我們的團隊維護了一個 Claude Opus 5.5 範例的視覺收藏。其中一個條目是由 @twoclipping 分享的循環 UI 動畫。所附的 GIF 是創作者成果的摘錄,並非我們團隊的重製。
這個提示詞一開始要求 8–12 個 UI 狀態、黑白調色盤或單一強調色,以及一段約 120 BPM 的免版稅音樂軌道。接著它描述了一個在這些狀態之間變形的連續形狀,而不是在不相關的畫面之間切換。
如果你要改編這個範例,請先決定那些輸入內容。一個按鈕、載入器、播放器、滑桿和圖表是好的起點;加入足夠的狀態以符合提示詞要求的範圍。然後閱讀完整的提示詞以了解製作限制,並在要求代理渲染之前提供其餘的輸入內容。
這就是我們希望這個函式庫能支援的瀏覽流程:檢查結果、閱讀公開的提示詞、確認設定,並加以改編。這個收藏橫跨七個類別,我們持續新增附有原始創作者連結的範例。

函式庫:https://github.com/LeaddeOpenLab/awesome-opus-5-5-video-prompts
原始範例與提示詞來源:https://x.com/twoclipping/status/2103273003555402193
我們並未獨立重製每一個條目。當你嘗試使用分享的創意程式設計提示詞時,通常會發現哪些設定資訊是缺失的?
披露:我協助維護這個收藏。本文是在 AI 協助下起草的。
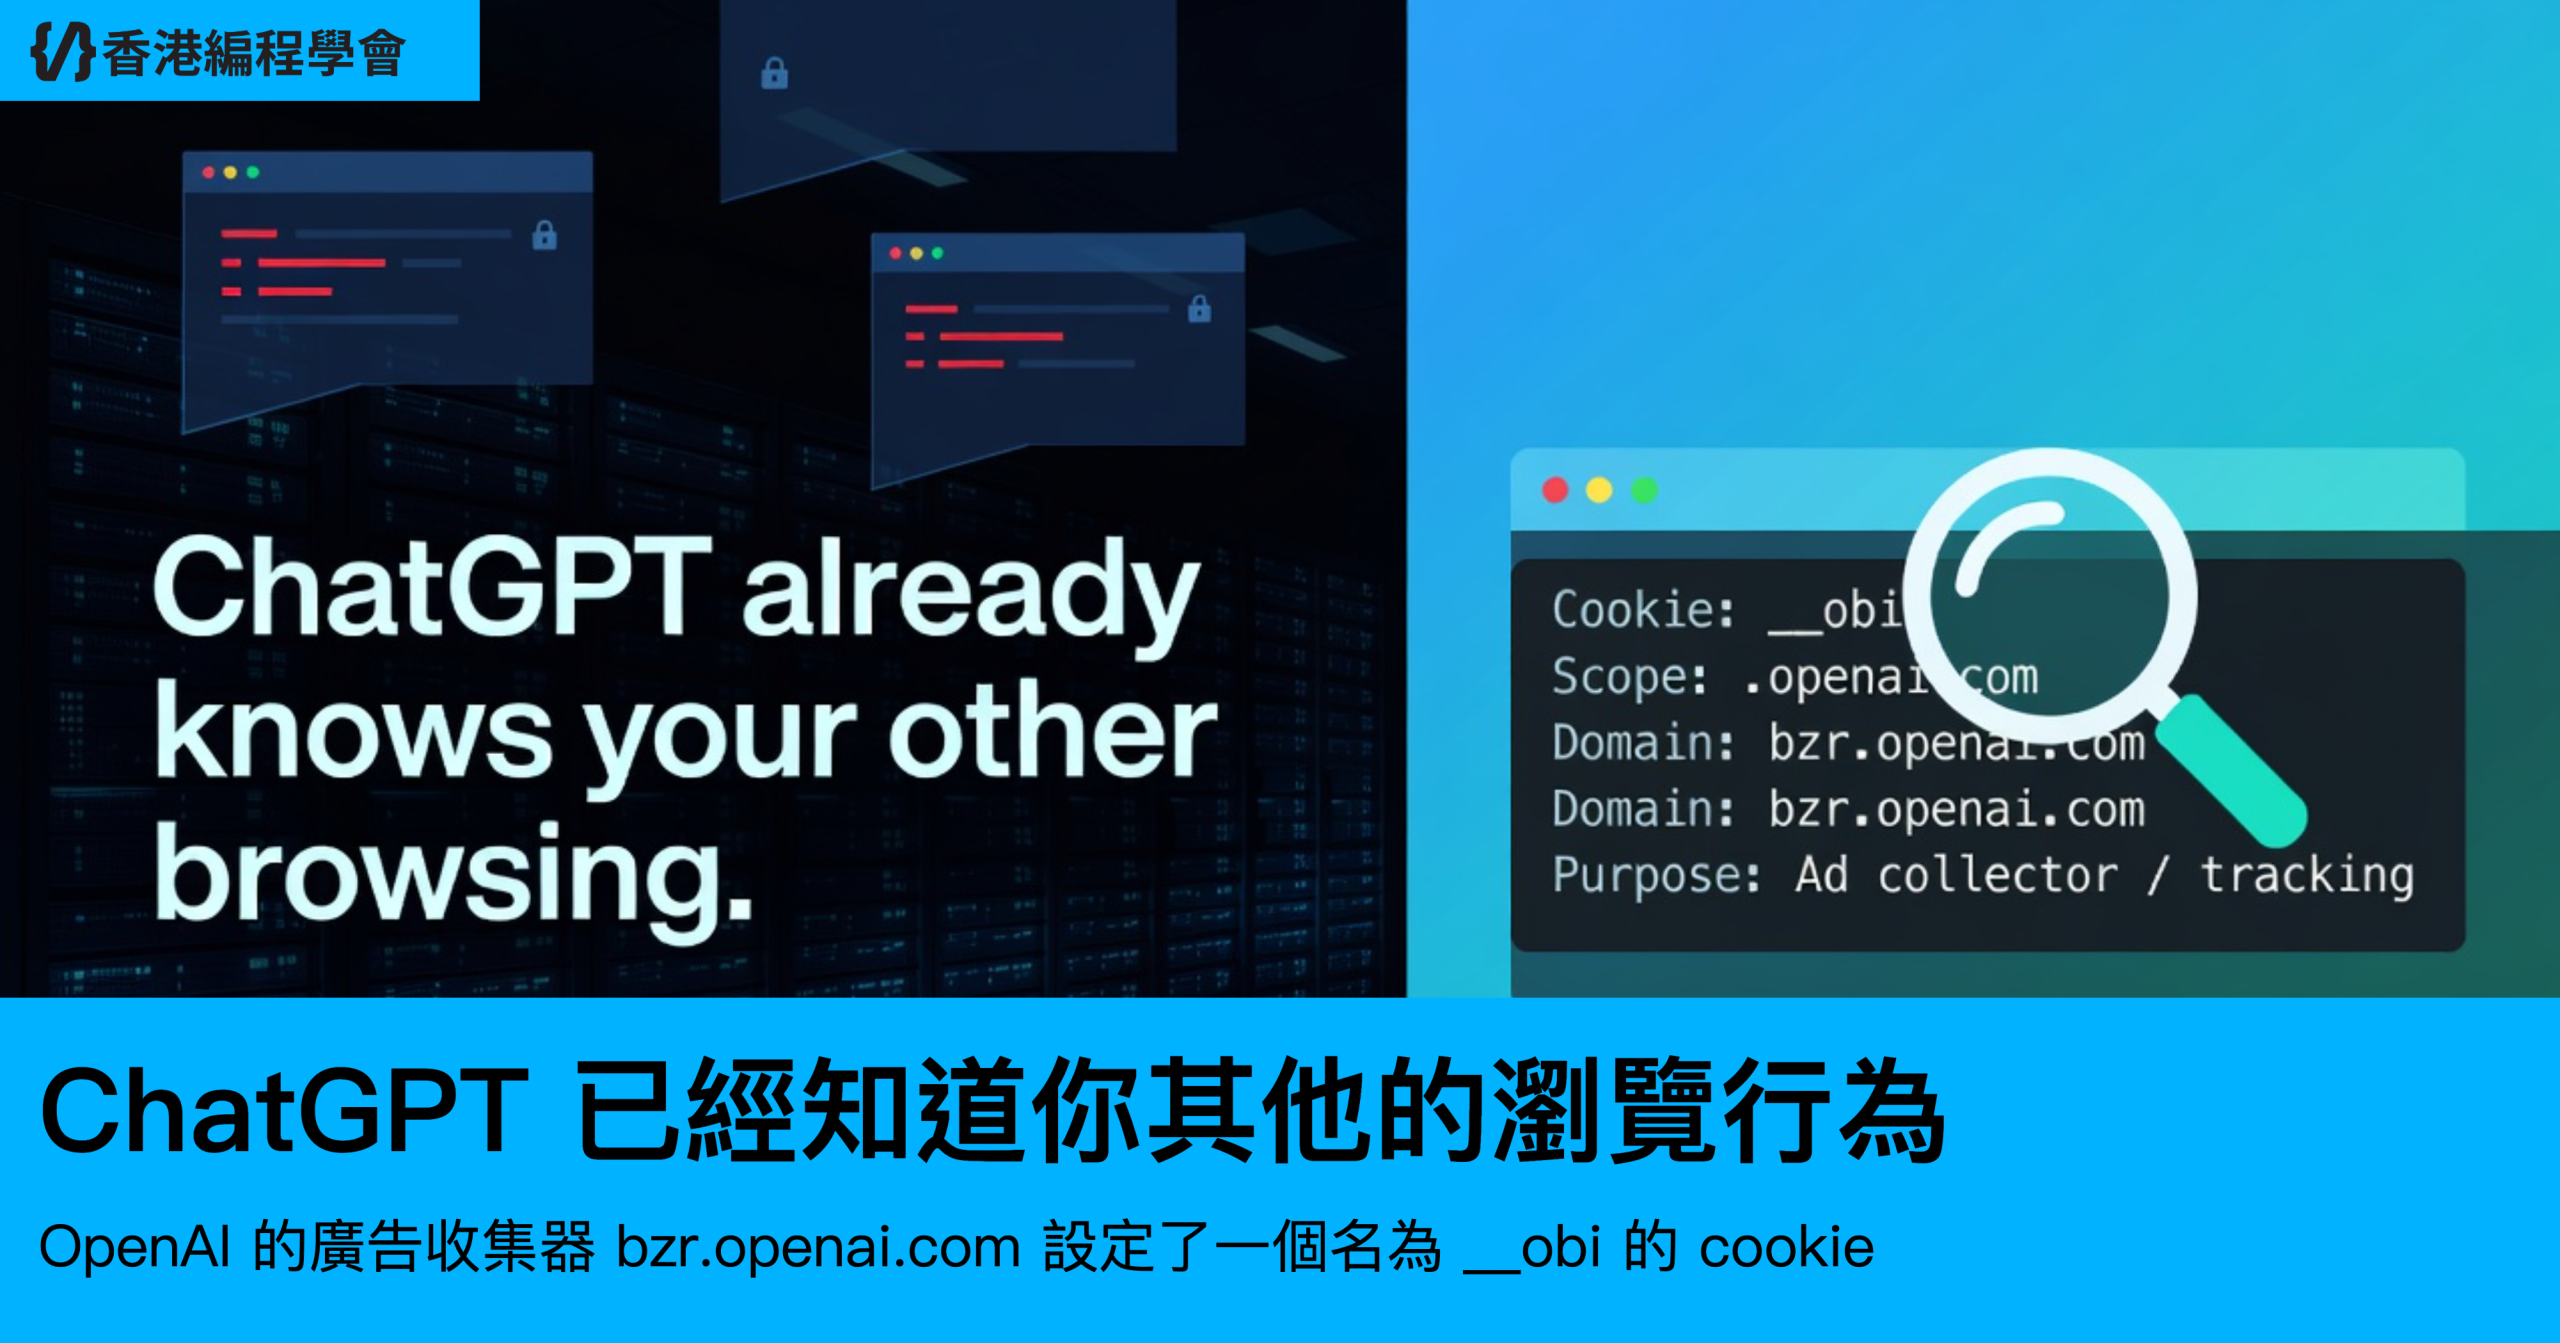
OpenAI 的廣告收集器位於 bzr.openai.com,它設定了一個名為 __obi 的 cookie。此 cookie 的作用域限定在 .openai.com,其值是在你使用 ChatGPT 時寫入,並與你的 ChatGPT 帳戶綁定,之後會從你造訪的一般網站發送回 OpenAI。任何在 ChatGPT 上購買廣告的公司,都會在其自家網站安裝一段 OpenAI 程式碼,就像零售商早已執行 Meta 和 Google 的標籤一樣。當該程式碼載入時,__obi 就會連同你在該頁面上的行為一起傳送給 OpenAI:你搜尋的產品、閱讀的文章、購買行為。OpenAI 可以將所有這些解析回你的帳戶。
一位研究人員在 Android 手機上重現了完整的機制,使用兩種獨立的擷取方法進行確認,並與涵蓋 936 個廣告商像素、1,029 個主機名稱的數個月流量進行交叉比對。
三步驟同步機制
在 chatgpt.com 上,用戶端會產生 16 個隨機位元組,並呼叫 POST /backend-api/bazaar/obi/sync-token(或在你登出時使用 /backend-anon/)。後端會回傳一個 RS256 JWT,將帳戶 sub 與 obi 識別碼綁定,使用 aud: bzr.openai.com 將其限定在收集器,並在 60 秒後過期。該權杖還會帶有 purpose: obi_sync 和 consent_decision: analytics_allowed。(bzr 是 bazaar,即 OpenAI 內部對廣告平台的稱呼;發行服務則是 wadi。)
用戶端接著會將該權杖以跨站方式 POST 到 bzr.openai.com/v1/obi/sync,並得到以下回應:
Set-Cookie: __obi=...; Domain=.openai.com; HttpOnly;
            Max-Age=31536000; Path=/; SameSite=none; Secure
進入全螢幕模式
退出全螢幕模式
SameSite=None 搭配 Secure 正是 cookie 需要用來搭乘跨站請求的設定,而 Max-Age 為一年。JWT 中的 obi 值與 cookie 值完全相同。在廣告商頁面上觀察到的其他 OpenAI cookie 都被瀏覽器阻擋;__obi 是唯一以 SameSite=None 設定的 OpenAI 識別碼。
從那時起,廣告商網站就會將它回傳。在存放有 __obi 的手機上,從廣告商頁面發送到 OpenAI 主機的每個請求類別都帶有此 cookie。像素 SDK 有一條省略憑證的程式碼路徑,但這並沒有影響:瀏覽器會在任何 OpenAI 程式碼執行前,就將 cookie 附加到載入 SDK 的 <script src> 請求。載入標籤就會揭露此識別碼。
還有什麼會一起傳送
相同的 SDK 會從廣告商頁面抓取身分資訊。酬載會依來源標記四種來源:in 表示廣告商故意傳遞的值,而 fm、ht、js 則是從表單欄位、渲染的頁面文字和標籤管理器匯流排抓取的值。被抓取的身分資訊數量超過廣告商提供的身分資訊,685 個事件對 255 個事件。SDK 會用自己的函式取代 window.dataLayer.push,讀取 adobeDataLayer,並透過解析 gtm.js 標籤中的 l= 參數來尋找重新命名的 GTM 層。目前版本會從匯流排取得電子郵件和電話;0.1.31 版還會取得姓名和地理位置,直到 8 月 27 日範圍被縮小為止。
電子郵件、電話和姓名在傳輸前會經過 SHA-256 雜湊。國家、地區、城市和郵遞區號則以明文傳送,而郵遞區號是被收集最多的表單欄位,在 28 個網站上共 100 個事件。網址會被簡化為來源加上路徑,在 23,929 個觀察到的案例中沒有一個帶有查詢字串,但路徑會被保留,而到達收集器的路徑中包含醫療狀況、債務解決漏斗和訴訟受理表單。一個拒絕清單會丟棄密碼、一次性驗證碼、信用卡號、社安號、生日、病史、診斷和法庭欄位。在 881 個已知設定的像素中,有 638 個開啟了自動配對,包括樣本中所有的信用和貸款廣告商。
在測試裝置上,單一 __obi 值從 12 個商業網站以 13 個像素 ID 發送到 OpenAI,包括 Chewy、Wayfair、ThriftBooks、Eventbrite、HelloFresh、Coursera 和 SeatGeek,每個都以 202 狀態接受。在更廣泛的擷取中,30 個不同的 __obi 值中有 12 個出現在超過一個廣告商下,其中一個出現在十個廣告商下。
即使登出也會執行
在 932 個解碼的同步權杖中,有 736 個是 account_user,196 個是匿名,而匿名主體與帳戶主體一樣穩定:每個裝置一個值,至少持續 27 天。
OpenAI 的 cookie 政策將 __obi 列在「分析」類別下,有效期一年,而且它是該區段中唯一的項目;政策指出分析 cookie 幫助 OpenAI 了解其服務的表現。OpenAI 將同意分為 oai_consent_analytics 和 oai_consent_marketing,而每個解碼的同步權杖都帶有 analytics_allowed。允許分析但拒絕行銷的使用者仍然會收到此 cookie 和跨站解析。
研究人員在 9 月 14 日向 OpenAI 提出兩個問題:為什麼 __obi 被歸類為分析,以及拒絕行銷是否能阻止它。OpenAI 支援團隊確認收到詢問,表示會在內部分享這些觀察,但兩個問題都沒有回答。
如果你運行這些系統,這代表什麼
此機制是標準的廣告技術。Meta 幾年前就建立了結構上等同的系統:已登入的帳戶、像素觸發時的第三方 cookie、解析到個人檔案的站外轉換。在 AI 聊天產品上運行這套系統是新的,而且很重要,因為人們會告訴這些系統他們永遠不會發佈到社群網路的事情,而且這些系統越來越會為他們採取行動。
此行為是在 Android 版 Chrome 上觀察到的。Safari 的智慧追蹤預防會阻擋所有第三方 cookie,而 iOS 上的 Chrome 底層是 WebKit,因此沒有 iOS 瀏覽器會運行它;桌面版 Chrome 尚未測試。閘控相當寬鬆:大約每五個 ChatGPT 工作階段會產生一個同步權杖,而行動網頁用戶端在完全沒有同步的情況下就會投放廣告,因此你可能會看到沒有附加 cookie 的像素觸發。伺服器端的 join 並未直接觀察;202 狀態確認收集器接受了帶有 cookie 的事件,而解析到帳戶則來自於設計本身。
如果你經營其中一個廣告商網站,你無法看到任何這些情況。__obi 屬於你的腳本無法讀取的域名,因此你安裝了一個轉換像素,卻無法得知你的訪客正被解析到 ChatGPT 身分。該像素的另一個 cookie __obref,是以每個網站不同的值設定在你自己的域名上,並不會跨站:在觀察到的 2,860 個值中,有 2,828 個僅出現在一個廣告商下。
https://dev.to/randomchaos/chatgpt-already-knows-your-other-browsing-1poj
https://www.worldprogramming.org/posts/chatgpt-already-knows-your-other-browsing-avxaji

如果你曾經和 SQL 搏鬥過,這篇文章就是為你準備的。
AI 可以產生可執行的 SQL 語句,但它常常不太可靠。SQLazy 將 SQL 開發轉變成逐步、可驗證且可稽核的工作流程,並透過編譯器確保最終輸出正確。SQLazy 的運作方式?SQLazy 不會一次產生一大塊 SQL。而是將 SQL 開發轉變成逐步且可追蹤的工作流程:
- 使用半自然語言語法來描述每個步驟的作用。
- 在每個步驟驗證邏輯 – 中間結果可以檢查。
- 讓編譯器產生最終的 SQL。
希望能得到你的支持 — 每個讚和留言都很重要:
https://www.producthunt.com/products/sqlazy?utm_source=other&utm_medium=social
非常感謝。
https://dev.to/esproc_spl/sqlazy-is-live-on-product-hunt-today-2id0
https://www.worldprogramming.org/posts/sqlazy-is-live-on-product-hunt-today-suz5dh
每一個 Playwright 測試套件一開始都很乾淨。二十個測試全部綠燈,九十秒內跑完。然後它開始成長。
到了第五十個測試時,有人加入了 waitForTimeout 來「修復」競爭條件。到了第一百個測試時,測試套件大概每四次執行就會失敗一次——而且從來不是同一個測試失敗兩次。人們開始重新執行管線直到它變綠為止。到那個時候,測試套件已經不再是安全網,而是變成了稅負。
我看過這個現象在足夠多的專案上發生,注意到它幾乎總是由相同的五個原因造成。它們沒有一個是特別複雜的。它們如下,每一個都附上對應的修復方式。
1. waitForTimeout 不是等待,它是一場賭博
這是最大的一個。它在測試第一次出現間歇性失敗時就會出現,有人會伸手拿最快速的修復方式:
await page.click('#submit');
await page.waitForTimeout(2000);        // ← the bet
await expect(page.locator('.result')).toBeVisible();
Enter fullscreen mode
Exit fullscreen mode
這場賭博是假設兩秒鐘永遠都足夠。在你的筆電上是足夠的。在凌晨三點負載較重的 CI 執行器上有時就不夠了。而在那些確實足夠的日子裡,你仍然要付出兩秒鐘的代價——乘以一百個測試,你就為每次執行無謂地多增加了三分鐘。
修復方式:等待你真正需要的東西。
await page.click('#submit');
await expect(page.locator('.result')).toBeVisible();   // auto-waits, up to the timeout
Enter fullscreen mode
Exit fullscreen mode
Playwright 的斷言已經會自動重試直到通過或逾時。你幾乎不需要明確的等待。當你真的需要時——例如點擊觸發了一個 XHR,而你需要它的結果才能繼續——就等待那個特定的事情:
const response = page.waitForResponse(res => res.url().includes('/api/order'));
await page.click('#submit');
await response;
Enter fullscreen mode
Exit fullscreen mode
用 lint 來強制執行,而不是靠紀律。 紀律在截止期限壓力下會失效。加入 eslint-plugin-playwright 並將 no-wait-for-timeout 開啟為錯誤。現在管線會拒絕它,沒有人需要在審核時人工檢查。
2. 共用資料的測試在平行執行時會互相碰撞
這個很狡猾,因為它只有在你開啟平行執行後才會出現。
test('registers a new user', async ({ page }) => {
  await registerUser(page, '[email protected]', 'Password123!');
  await expect(page.locator('.welcome')).toBeVisible();
});
Enter fullscreen mode
Exit fullscreen mode
單獨執行時完美無缺。當你用兩個 worker 執行它,或是在沒有重置資料庫的情況下執行兩次,第二個就會碰到「email already registered」。這個失敗看起來像是註冊錯誤。其實不是。這是你的測試資料造成的。
修復方式:為每個測試產生唯一的資料,絕對不要硬編碼。
const user = {
  email: `qa.${randomUUID().split('-')[0]}@example.com`,
  password: 'Str0ng!Passw0rd',
};
Enter fullscreen mode
Exit fullscreen mode
寫一個小型的工廠模組是很值得的。而且——這聽起來過度,直到它幫你省了一天時間——為工廠本身撰寫單元測試。一個會默默產生重複資料的工廠會造成看起來完全像是應用程式錯誤的失敗,你會在錯誤的程式碼庫中花上好幾小時才懷疑到它。斷言「2000 個產生的 email 都是唯一的」只需要三十毫秒,並能消除這一整類的混亂。
3. 每個測試都重新登入一次
這不完全是不穩定,但它會讓其他問題更加惡化。如果每個測試一開始都要填寫登入表單,你就要為每個測試付出三到五秒,並給自己額外一百次機會在這個最常執行的流程上碰到計時失敗。
修復方式:登入一次,儲存 session,重複使用它。
建立一個設定專案:
// tests/auth.setup.ts
setup('authenticate', async ({ page }) => {
  await page.goto('/login');
  await page.getByLabel('Username').fill(process.env.TEST_USERNAME!);
  await page.getByLabel('Password').fill(process.env.TEST_PASSWORD!);
  await page.getByRole('button', { name: 'Login' }).click();

  await expect(page.getByRole('link', { name: 'Logout' })).toBeVisible();
  await page.context().storageState({ path: 'playwright/.auth/user.json' });
});
Enter fullscreen mode
Exit fullscreen mode
將它設定為相依性:
projects: [
  { name: 'setup', testMatch: /.*.setup.ts/ },
  {
    name: 'chromium',
    use: { ...devices['Desktop Chrome'], storageState: 'playwright/.auth/user.json' },
    dependencies: ['setup'],
  },
]
Enter fullscreen mode
Exit fullscreen mode
在一個 200 個測試的套件中,這通常能為每次執行減少好幾分鐘。它通常是可取得的最大單一速度改善。
有一個細節很重要:讓設定專案大聲斷言登入確實成功。如果它默默失敗,每個下游測試都會以令人困惑的方式失敗,而你會去除錯錯誤的東西。
4. 綁定在標記而不是意義上的 Locator
await page.click('.btn-primary.submit-form > span:nth-child(2)');
Enter fullscreen mode
Exit fullscreen mode
這個今天能通過,但在下一次有開發者把東西包在 div 裡時就會壞掉。更糟糕的是,它會「默默」壞掉,因為失敗訊息完全沒有告訴你實際上發生了什麼改變。
修復方式:根據使用者感知的東西來定位。
await page.getByRole('button', { name: 'Submit order' }).click();
Enter fullscreen mode
Exit fullscreen mode
這個優先順序很穩固:
-
getByRole—— 能承受重新設計,符合使用者和螢幕閱讀器看到的內容 -
getByLabel—— 將欄位與其可存取標籤繫結 -
getByTestId—— 當標記沒有提供任何語義資訊時 - CSS/XPath —— 最後手段
還有一個值得一提的額外好處:如果 getByRole 和 getByLabel 找不到你的元素,這通常代表應用程式中存在真正的無障礙問題。你的測試套件開始免費兼作無障礙冒煙測試。
5. 在所有東西上都失敗的視覺測試
團隊加入視覺回歸測試,在每個不相關的變更上都得到失敗,然後在一個月內就把它關掉。有三個原因:
動畫。 在轉場中間拍的截圖永遠不會符合。全局停用它們:
expect: {
  toHaveScreenshot: { animations: 'disabled', maxDiffPixelRatio: 0.02 },
}
Enter fullscreen mode
Exit fullscreen mode
不同機器上的字型渲染。 macOS 和 Linux 的抗鋸齒方式不同,所以在本機產生的基準永遠不會與 CI 相符。要嘛在 Docker 內產生基準,讓每個人都與相同的渲染比較;或者保留一個小的像素容忍度。
真正動態的內容。 時間戳、頭像、廣告欄位。遮罩它們:
await expect(page).toHaveScreenshot('dashboard.png', {
  mask: [page.locator('time'), page.locator('.ad-slot')],
});
Enter fullscreen mode
Exit fullscreen mode
並且優先選擇元件層級的快照,而不是全頁面的。全頁面基準在任何地方有任何改變時都會失敗。只有結帳表單的快照只會在結帳表單改變時失敗——這才是你真正想要的訊號。
這五個問題底層的模式
這五個問題的每一個都是同樣的錯誤,只是穿著不同的衣服:將關於時機或狀態的假設編碼進去,而不是等待真正的事情發生。
固定的延遲假設了時機。硬編碼的 email 假設沒有人同時在執行。CSS 路徑 locator 假設了 DOM 的形狀。全頁面快照假設頁面上沒有其他東西會改變。
用實際的條件取代每個假設,不穩定就會消失。不是「大部分消失」——而是完全消失。不穩定的測試套件並不是瀏覽器測試的固有特性,它們是建立在假設上的測試套件的特性。
一個實際的修復順序
如果你繼承了一個不穩定的測試套件,不要重寫它。依照這個順序進行——先做最便宜且影響最大的:
-
加入 lint 規則 讓它幫你找出每一個
waitForTimeout - 加入認證快取 —— 最大的速度改善,只碰一個檔案
- 修復前三個最不穩定的測試 —— 你的 CI 歷史知道它們是哪些
- 在你碰到每個檔案時替換脆弱的 locator,而不是一次大掃除
- 當你下次碰到碰撞時加入資料產生機制
你通常從前兩項就能得到大部分的好處。
我把這些模式——加上 API 測試、CI 分片和 Docker 設定——打包成一個 Playwright 入門套件,因為我每次專案都在重複建立同樣的東西。但這篇文章裡的所有內容都可以獨立使用;它們都不需要購買任何東西。

CLAUDE.md 中的規則是一種請求。Hook 則是一種保證。將這兩者混淆是我看到最常見的設定錯誤:團隊把「永遠不要提交機密」寫成文字,然後當機密真的被提交時感到驚訝。這篇文章是我使用的區分方式:什麼該寫成文字、什麼該放在 Hook,以及決定層級的四階梯。
單句總結兩者的差異
文字設定改變模型「嘗試要做什麼」。Hook 和 CI 則改變「什麼事有可能做到」。任何絕對不能發生的事都不該放在文字中,因為文字是被取樣的,而不是被執行的。
四階執行保障階梯
對於任何你想要的規則,先問它實際上需要哪個層級:
Level 1  Linter/types/CI      確定性,捕捉大部分程式碼問題
Level 2  Hooks (PreToolUse)   在指令或檔案執行前就加以阻擋
Level 3  Scoped rules         文字,只針對符合的檔案載入
Level 4  Always-on config     文字,每一次呼叫都值得花費上下文
Enter fullscreen mode
Exit fullscreen mode
這個階梯是依照可靠性排序,而最可靠的那端是免費的(不消耗 token)。每把一條規則往下推一層,就能節省上下文並移除一種失敗模式。
什麼該放在 Hook 中
我自己設定中的具體範例:
{
  "hooks": {
    "PreToolUse": [
      { "matcher": "Bash", "command": "block-dangerous.sh" },
      { "matcher": "Edit|Write", "command": "protect-env.sh" }
    ]
  }
}
Enter fullscreen mode
Exit fullscreen mode
-
破壞性指令:
rm -rf在目標目錄外、強制推送至 main、drop table。在 PreToolUse Hook 中用正規表達式就能確定地阻擋這些行為。寫成文字的「使用 rm 時要小心」大概十次有九次有效,但你只會聽說那第十次。 -
檔案保護:
.env、金鑰、產生出的檔案。Hook 會回傳阻擋原因,然後 Agent 會自行調整。只有在嘗試的那一刻才會消耗 token。 - 格式閘道:透過 Hook 在儲存時執行 prettier/eslint,而不是在設定中寫「永遠格式化你的程式碼」。確定性、零上下文消耗。
什麼該放在文字設定中
Hook 無法決定的事,因為它們需要判斷力:
- 完成定義:在這個專案中「已驗證」代表什麼。Hook 可以執行測試;只有文字能告訴 Agent 當測試失敗時該怎麼做(修正,而不是還原並繼續)。
- 優先順序:最小的 diff 獲勝、先調查再修正、驗證後就停止。這些塑造選擇,而不是動作。
- 模型無法推斷的上下文:為什麼認證機制中有那個奇怪的 workaround、程式碼庫哪些部分是產生的、誰在使用這個 API。
陷阱:把 CI 可修正的規則放在文字中
最明顯的跡象是 CLAUDE.md 中任何以「永遠執行」或「永遠不要提交」開頭的句子。如果 CI 可以檢查,就應該讓 CI 去檢查。每把一條 linter 規則重複寫在文字中,就是把上下文浪費在機器已經保證的事情上,而且當兩者出現落差時,就是一個等待發生的矛盾。
我們的工具組把文字保留給判斷力,並把所有可檢查的事項往下推到階梯的下層。這也是為什麼驗證器會拒絕佔位符的指令檔案:重述 linter 的文字比沒有檔案還糟糕,因為它會訓練你停止閱讀自己的設定。
當你沒有 Hook 系統時
較舊的設定(純 .cursorrules、裸的 AGENTS.md)沒有 Hook 層。階梯依然適用,只是往下掉一階:CI 和 linter 負責硬性保證,文字負責判斷,而「把硬性保證寫在文字中」的落差則由 git 本身的 pre-commit hook 來涵蓋,這是每個設定都有的。
相關閱讀
- 什麼是好的 AI 程式碼規則,以及是什麼讓 Agent 忽略它們:這個區分的文字面。
- 300 行指令預算:為什麼花在文字規則上的上下文必須是值得的。
- 為你的 Agent 設定做版本控制:Hook 也該放在 git 中。
我們的工具組已預先內建這個區分:文字用於判斷,Hook 與驗證器規則用於保證,皆收錄於 AgentConfig Studio。先用 Next.js 試用這個方法:免費樣本工具組(MIT)。
https://dev.to/piekwerk/config-files-vs-hooks-where-agent-enforcement-actually-belongs-2gi8
邊界限制最先失敗。不是模型。不是 schema。是上限。我不再詢問代理是否「真的在思考」,而是開始問一個更笨的問題,這個問題依然能見血。如果工具掛起,這個 while 會永遠停不下來嗎?
這個問題不浪漫。它也是讓共享的箱子不會變成熱燈的那個問題。我想要一個可以在星期一重新執行的數字,而不是來自已經奉承過我的聊天記錄的感覺。
我讀過的大多數代理重試程式碼都是一個穿著風衣的迴圈。你知道那件風衣。try、except、sleep、continue,也許還有一句註解寫著「要有韌性」。沒有預算的韌性只是無上限的帳單。作者有設定嘗試次數上限嗎?他們有設定執行時間上限嗎?還是他們只限制了自己的樂觀程度?
我做了一個評分器。不是排行榜。是一個有意見的 lint。它讀取 Python,遍歷 AST,並以我希望程式碼審查能做到的方式為重試輔助函式評分:邊界限制優先,詩意永遠不要。產出物才是重點。如果你把這篇文章裡的所有產品名稱都刪掉,你應該還是能儲存檔案並得到相同的整數。
揭露:本文是作為 MonkeyCode 的產品推廣所準備。
當我需要一個我在晚上 11 點不想手寫的候選迴圈時,我會透過 MonkeyCode 詢問一個免費模型。然後我把輸出丟進 fixtures/,並拒絕信任它,直到評分器印出分數為止。免費伺服器選項不是那個步驟的吉祥物。它是實驗的後半段,是 time.sleep 遇到排程雜訊的那一半。我的筆電是個糟糕的證人。它太快了,而且它喜歡我。
我實際編碼的評分標準
我不評「推理品質」。我評的是你即將部署的產出物中是否存在停止條件。它們是不同的論文。其中一篇是主題演講。另一篇是單元測試。
重試輔助函式從零開始。我為嘗試次數上限、執行時間逾時、退避、抖動,以及隨請求一起傳遞的冪等性金鑰加分。我為沒有中斷預算的 while True,以及無法看到截止時間的 sleep 扣分。這很嚴苛嗎?很好。一個能活得比你的耐心還久的迴圈並不穩健。它是一條塗層被剝掉的保險絲。
將此儲存為 loop_hygiene.py。它是整個靜態的一半。
#!/usr/bin/env python3
"""Score retry-loop hygiene from Python source. Fixture-calibrated, not a bake-off."""
from __future__ import annotations

import ast
import json
import sys
from dataclasses import asdict, dataclass, field
from pathlib import Path

ATTEMPT_NAMES = {"max_attempts", "max_retries", "retries", "attempts", "n_tries"}
TIMEOUT_NAMES = {"timeout", "deadline", "max_seconds", "wall_timeout", "budget_s"}
BACKOFF_NAMES = {"backoff", "backoff_s", "delay", "base_delay"}
JITTER_NAMES = {"jitter", "jitter_s", "jitter_ratio"}
IDEM_NAMES = {"idempotency_key", "idempotency", "request_id", "dedupe_key"}


@dataclass
class LoopScore:
    path: str
    has_max_attempts: bool = False
    has_timeout: bool = False
    has_backoff: bool = False
    has_jitter: bool = False
    has_idempotency: bool = False
    unbounded_while: bool = False
    sleep_without_budget: bool = False
    score: int = 0
    notes: list[str] = field(default_factory=list)


class HygieneVisitor(ast.NodeVisitor):
    def __init__(self) -> None:
        self.names: set[str] = set()
        self.unbounded_while = False
        self.sleep_calls = 0
        self.breaks_in_loop = 0

    def visit_Name(self, node: ast.Name) -> None:
        self.names.add(node.id)
        self.generic_visit(node)

    def visit_While(self, node: ast.While) -> None:
        constant_true = (
            isinstance(node.test, ast.Constant) and node.test.value is True
        ) or (
            isinstance(node.test, ast.Constant) and node.test.value == 1
        )
        if constant_true:
            self.unbounded_while = True
        for child in ast.walk(node):
            if isinstance(child, ast.Break):
                self.breaks_in_loop += 1
        self.generic_visit(node)

    def visit_Call(self, node: ast.Call) -> None:
        func = node.func
        name = ""
        if isinstance(func, ast.Attribute):
            name = func.attr
        elif isinstance(func, ast.Name):
            name = func.id
        if name in {"sleep", "usleep"}:
            self.sleep_calls += 1
        self.generic_visit(node)


def score_source(path: Path, src: str) -> LoopScore:
    tree = ast.parse(src)
    v = HygieneVisitor()
    v.visit(tree)
    row = LoopScore(path=str(path))
    row.has_max_attempts = bool(ATTEMPT_NAMES & v.names)
    row.has_timeout = bool(TIMEOUT_NAMES & v.names)
    row.has_backoff = bool(BACKOFF_NAMES & v.names)
    row.has_jitter = bool(JITTER_NAMES & v.names)
    row.has_idempotency = bool(IDEM_NAMES & v.names)
    row.unbounded_while = v.unbounded_while and v.breaks_in_loop == 0
    budget = row.has_max_attempts or row.has_timeout
    row.sleep_without_budget = v.sleep_calls > 0 and not budget

    n = 0
    if row.has_max_attempts:
        n += 2
        row.notes.append("+2 attempt cap")
    if row.has_timeout:
        n += 2
        row.notes.append("+2 wall clock")
    if row.has_backoff:
        n += 1
        row.notes.append("+1 backoff")
    if row.has_jitter:
        n += 1
        row.notes.append("+1 jitter")
    if row.has_idempotency:
        n += 2
        row.notes.append("+2 idempotency key")
    if row.unbounded_while:
        n -= 3
        row.notes.append("-3 unbounded while")
    if row.sleep_without_budget:
        n -= 2
        row.notes.append("-2 sleep with no ceiling")
    row.score = n
    return row


def main(argv: list[str]) -> int:
    root = Path(argv[1] if len(argv) > 1 else "fixtures")
    rows = []
    for path in sorted(root.glob("*.py")):
        rows.append(score_source(path, path.read_text(encoding="utf-8")))
    print(json.dumps([asdict(r) for r in rows], indent=2))
    return 0


if __name__ == "__main__":
    raise SystemExit(main(sys.argv))
進入全螢幕模式
退出全螢幕模式
像測試一樣執行它,而不是像示範一樣。
mkdir -p fixtures
python3 loop_hygiene.py fixtures/
進入全螢幕模式
退出全螢幕模式
如果該指令沒有印出任何東西,你得到的是一個空資料夾,而不是及格的分數。空也不是有韌性。
四個測試檔,四個我能捍衛的數字
我用四個我故意寫的檔案來校準評分器。這不是關於任何具名模型的宣稱。這是宣稱當我彎曲它時,尺不會彎曲。兩個測試檔是當你說「讓它穩健」時,聊天視窗會吐出的「在 PR 看起來沒問題」的迴圈。另外兩個是我實際願意放在會呼叫我的 cron 下的迴圈。
fixtures/a_trench_coat.py 就是那件風衣。
import time

def call_tool(url):
    while True:
        try:
            return fetch(url)
        except Exception:
            time.sleep(1)
進入全螢幕模式
退出全螢幕模式
fixtures/b_range_but_naked.py 看起來有邊界,直到你注意到請求可能被收取兩次。
import time

def call_tool(url):
    max_attempts = 5
    for _ in range(max_attempts):
        try:
            return fetch(url)
        except Exception:
            time.sleep(0.5)
    raise RuntimeError("gave up")
進入全螢幕模式
退出全螢幕模式
fixtures/c_budget.py 終於承認時間的存在。
import random, time

def call_tool(url, timeout=8.0):
    max_attempts = 5
    backoff = 0.2
    deadline = time.monotonic() + timeout
    for attempt in range(max_attempts):
        if time.monotonic() >= deadline:
            raise TimeoutError("wall clock")
        try:
            return fetch(url)
        except Exception:
            jitter = random.random() * 0.05
            sleep_for = min(backoff, max(0.0, deadline - time.monotonic()))
            time.sleep(sleep_for + jitter)
            backoff *= 2
    raise RuntimeError("attempts exhausted")
進入全螢幕模式
退出全螢幕模式
fixtures/d_idempotent.py 是我實際會在審查中主張的那一個。
import random, time, uuid

def call_tool(url, timeout=8.0, idempotency_key=None):
    max_attempts = 5
    backoff = 0.2
    jitter = 0.05
    deadline = time.monotonic() + timeout
    key = idempotency_key or str(uuid.uuid4())
    for attempt in range(max_attempts):
        if time.monotonic() >= deadline:
            raise TimeoutError("wall clock")
        try:
            return fetch(url, headers={"Idempotency-Key": key})
        except Exception:
            sleep_for = min(backoff, max(0.0, deadline - time.monotonic()))
            time.sleep(sleep_for + random.random() * jitter)
            backoff *= 2
    raise RuntimeError("attempts exhausted")
進入全螢幕模式
退出全螢幕模式
在我的機器上,針對這四個檔案,評分器印出的分數是 -5, 2, 6, 8。再讀一次。風衣不是「有點草率」。它是負分。審查者喜歡的 range 迴圈得到 2 分,因為它記住了 max_attempts,卻立刻忘記了時間、抖動和重複的副作用。有預算的迴圈是 6 分。冪等的那个是 8 分。這個差距就是實驗在運作。如果你的尺無法分辨保險絲和暖氣機,你只是在收集軼事。
我會部署得到 2 分的程式嗎?不會部署在我沒有監視的箱子上。我會說得到 8 分的程式已可投入生產嗎?還是會說不。一個 AST 訪問器無法看到隱藏在好看標頭名稱後面的非冪等 POST。這個數字是一道閘門,不是一枚勳章。
我實際貼上的提示詞
當我去煩一個免費模型時,我不會叫它「寫一個穩健的代理」。那個提示詞就是你得到風衣的方式。我會要求一個函式,其合約是評分器能看見的。
Write a Python function call_tool(url, timeout=8.0, idempotency_key=None)
that retries a failing fetch(). Requirements:
- max_attempts is an int cap
- timeout is a wall-clock budget using time.monotonic()
- exponential backoff plus jitter
- send Idempotency-Key on every attempt
- no while True
Return only the function.
進入全螢幕模式
退出全螢幕模式
然後我把回傳的任何東西存成 fixtures/model_candidate.py 並執行相同的指令。我不會先讀程式碼周圍的文字。先看整數。如果這聽起來很無禮,請問問自己,為什麼一個重試輔助函式值得擁有單元測試所沒有的禮貌。
模型有加入抖動,還是只是把 sleep(1) 穿上一件更漂亮的外套?它有命名 timeout 卻從未查詢時鐘嗎?名稱很便宜。訪問器更便宜。這就是整個把戲。
我的筆電一直在撒謊的那一半
靜態分數能抓住缺少上限的情況。它們抓不到紙面上存在、卻在真實延遲面前落敗的上限。所以我加入了一個動態探測。它故意很醜。一個模擬工具會在 0.25 秒、1 秒、3 秒後回應,然後就永遠不回應。被測試的迴圈必須尊重 max_attempts 和執行時間上限,而且行程必須結束。
#!/usr/bin/env python3
"""Dynamic probe. Label: run this; do not treat my laptop timings as yours."""
import threading
import time
from http.server import BaseHTTPRequestHandler, HTTPServer

DELAYS = [0.25, 1.0, 3.0, 999.0]
HITS = {"n": 0}

class SlowTool(BaseHTTPRequestHandler):
    def do_GET(self):
        i = min(HITS["n"], len(DELAYS) - 1)
        HITS["n"] += 1
        time.sleep(DELAYS[i])
        self.send_response(200)
        self.end_headers()
        self.wfile.write(b"ok")

    def log_message(self, fmt, *args):
        return

def main() -> None:
    server = HTTPServer(("127.0.0.1", 8765), SlowTool)
    t = threading.Thread(target=server.serve_forever, daemon=True)
    t.start()
    deadline = time.monotonic() + 10.0
    # Import YOUR candidate here and call it against http://127.0.0.1:8765/
    # If this process is still alive past deadline, the loop has no ceiling.
    while time.monotonic() < deadline:
        time.sleep(0.05)
    server.shutdown()
    print({"hits": HITS["n"], "exited_before_watchdog": True})

if __name__ == "__main__":
    main()
進入全螢幕模式
退出全螢幕模式
在我的筆電上,3 秒的延遲是一個禮貌的暫停。在共享的免費伺服器上,那個暫停會與其他人的工作以及箱子實際擁有的任何監控程式發生碰撞。如果你的停止條件是「我看轉圈看膩了」,伺服器不會替你看膩。這就是為什麼免費伺服器應該屬於這個方法,而不是屬於一句口號。延遲是證人。安靜的 SSD 是被告的朋友。
我不會為那一半發布對抗賽表格,因為我不會捏造模型名稱、硬體規格或永久性宣稱。協定就是結果。你讓候選程式對抗模擬工具。要嘛行程在 10 秒監控程式之前結束,不然你就是剛剛看著一個無邊界迴圈花掉別人的電。你希望被哪個結果驚訝,是整數還是生產環境?
這沒有測量的事
這沒有測量一個模型是否「比大多數開發者更會寫程式」。我完全不知道你怎麼抽樣那句話而不對自己說謊。它沒有測量 MCP 伺服器、社群知識庫,或代理是否其實是 if 陳述式。很多 if 陳述式都很誠實。不誠實的是那些拒絕成為帶有計數器的 if 陳述式的迴圈。
AST 評分器是一支手電筒。它會錯過藏在 exec、我沒有命名的裝飾器,或是因為有人認為那是架構而重新啟動自己的子行程中的重試。免費模型輸出會變化。免費伺服器不是 SLO。如果你需要固定的模型身分、保留的 CPU,或是會標明延遲的廠商合約,不要使用這個工作流程。請使用付費的、具名的端點,以及一個你可以 SSH 進去而不用猜測還有誰在同一台機器上的箱子。
誰應該跳過它:任何在出貨計費、醫療保健,或是圍繞非冪等收費的重試的人。8 分的衛生分數不是 PCI 稽核。如果你不打算閱讀產生的迴圈,也請跳過它。一個你忽略的評分器只是另一個儀表板,而儀表板不會在發票來之前呼叫你。
我仍然會在爭論「代理品質」之前先執行評分器。邊界限制在聊天中是可選的。在行程表中卻不是。如果你希望動態的那一半在不是你筆電的機器上變得醜陋,我已經把那個探測放在 MonkeyCode 的免費伺服器上,並讓延遲保持不誠實。先偷走這個測試架構。再來和我爭論評分標準。
https://dev.to/hackhub_6179/i-scored-retry-loops-boundedness-was-optional-pe7
https://www.worldprogramming.org/posts/i-scored-retry-loops-boundedness-was-optional-uihs26
然而,它認為恐懼會扭曲實際局勢。「我們的核心論點是,AI 週期正從『建置容量』轉向『證明回報』——這一轉型本質上偏重服務,並直接發揮印度 IT 在部署、整合、治理與舊系統現代化方面的優勢,」它表示。
該券商表示,價值正從資助 AI 建置的層級轉移到部署 AI 的層級。首先是企業軟體平台,接著是整合與運營這些平台的服務公司。
它表示,這就像雲端劇本重演:資本支出先行,報酬後至,惠及不同參與者,如同鐵路、光纖與 2015-19 年的雲端 J 曲線所見。以下是該券商對其五大 IT 股票推薦所給予的目標價與看法。
Tech Mahindra
Anand Rathi 表示,Tech Mahindra 即將進入 FY27,這是其三年轉型計劃的最後一年,驅動因素從毛利率恢復轉向高於同業的營收成長,背後有自計劃啟動以來最強勁的一季、加速的訂單動能、健康的訂單簿(企業需求無明顯惡化)、涵蓋顧問、平台、工程與夥伴關係的 Project Helix,以及其 Agentic Development & Modernization Services 產品組合。
LTM
Anand Rathi 表示,LTM 獲得強勁營收成長能見度支持,來自大型交易動能、關鍵 BFSI 與最大客戶帳戶的復甦、透過 Randstad 收購案在歐洲的策略擴張、Lakshya’31 成長策略的執行,以及透過提高股利支付比率來增加股東回報的空間。
Infosys
Anand Rathi 表示,Infosys 的 FY27 預計表現平淡;然而 BFSI(占 28%)與 EURS(占 13%)應會表現良好。FY28 預計將因 LTM 第一季大型交易 TCV 成長 30% 而改善,Anand Rathi 表示。AI 貨幣化上升(占營收 8.2%,從第三季到第一季 CQGR 成長 22%),加上 Topaz Fabric/Cobalt 與平台主導的收購案,預計將支持成長與毛利率。FY26-28E 調整後 EPS CAGR 為 7.8%,股利收益率 4.2%,FCF 收益率 8.1%,調整後 PEG 為 1.9 倍,提供估值支撐。
Persistent Systems
Persistent 仍處於領先業界成長的良好定位,受惠於透過 Sasva 與 iAURA 等平台強勁的 AI 主導執行、嚴謹的執行、在 BFSI(占營收 34%)與醫療保健(占營收 25%)加速的需求,以及擬議中的 Nagarro 收購案,該收購將擴大其歐洲布局、可觸及市場與長期成長機會。
Mphasis
Mphasis 定位良好,可搶占市占率,受惠於創紀錄高的業務管道(年增 28%),其中 AI 主導交易如今占約 70%,相較於 Mphasis AI 推出時的約 12%。此外,還有更高的穩態 TCV 基線、透過 Neo IP、Continuum AI 與 Tria 的平台主導執行,以及透過成果導向模式改善獲利能力。
Disclaimer: Business Today provides stock market news for informational purposes only and should not be construed as investment advice. Readers are encouraged to consult with a qualified financial advisor before making any investment decisions.